POST-TRAINING / OUR RESEARCH
Agentic RL
从可验证的任务,
到持续进步的 Agent。
探索训练数据的生成、过程奖励与策略优化。
阅读我们的研究,了解每一项工作的设计与实验证据。
SEARCH AGENTS / CREDIT ASSIGNMENT
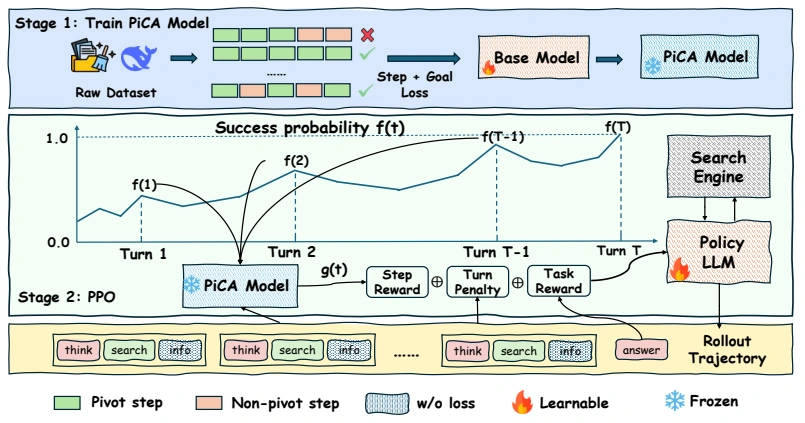
PiCA
让每一步探索,都有学习的方向。
识别搜索轨迹中的关键步骤,构建依赖历史的过程奖励,通过 PPO 改善 Agent 的多轮搜索能力。
过程奖励 · 7 项问答基准详细介绍 ↗
VERIFIABLE DATA / TASK SYNTHESIS
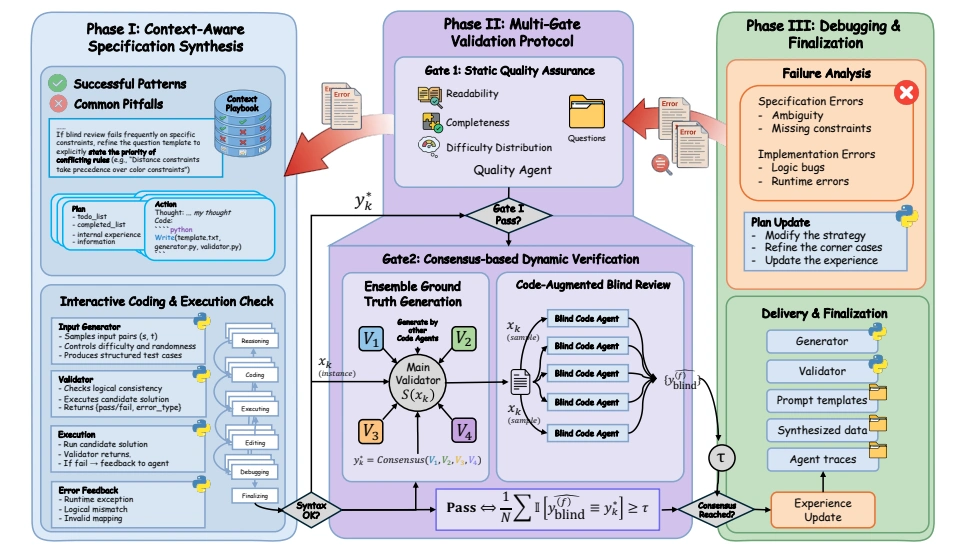
SSLogic
让训练任务的规则,也能持续演化。
由 Agent 编写、验证并迭代生成器与验证器,扩展可验证逻辑任务族,为强化学习提供训练信号。
953 个任务族 · 21,389 条实例详细介绍 ↗
02 / RESEARCH PAPERS
任务合成与奖励学习,共同支持模型能力的提升。