组织试错轨迹
采样解答并构造验证过程,保留难度不同、尝试次数不同的训练轨迹。
S²R: Teaching LLMs to Self-verify and Self-correct via Reinforcement Learning
推理中的检查与纠错,可以成为可学习的行为。S²R 把求解、验证与修正组织成训练轨迹,再通过强化学习,鼓励模型在推理时自主分配尝试与检查的机会。
研究先构造包含成功与失败尝试、自我验证和修正的轨迹,以监督微调初始化行为。随后比较结果级和过程级强化学习,分析不同反馈粒度怎样影响模型的验证、纠错与最终解题表现。
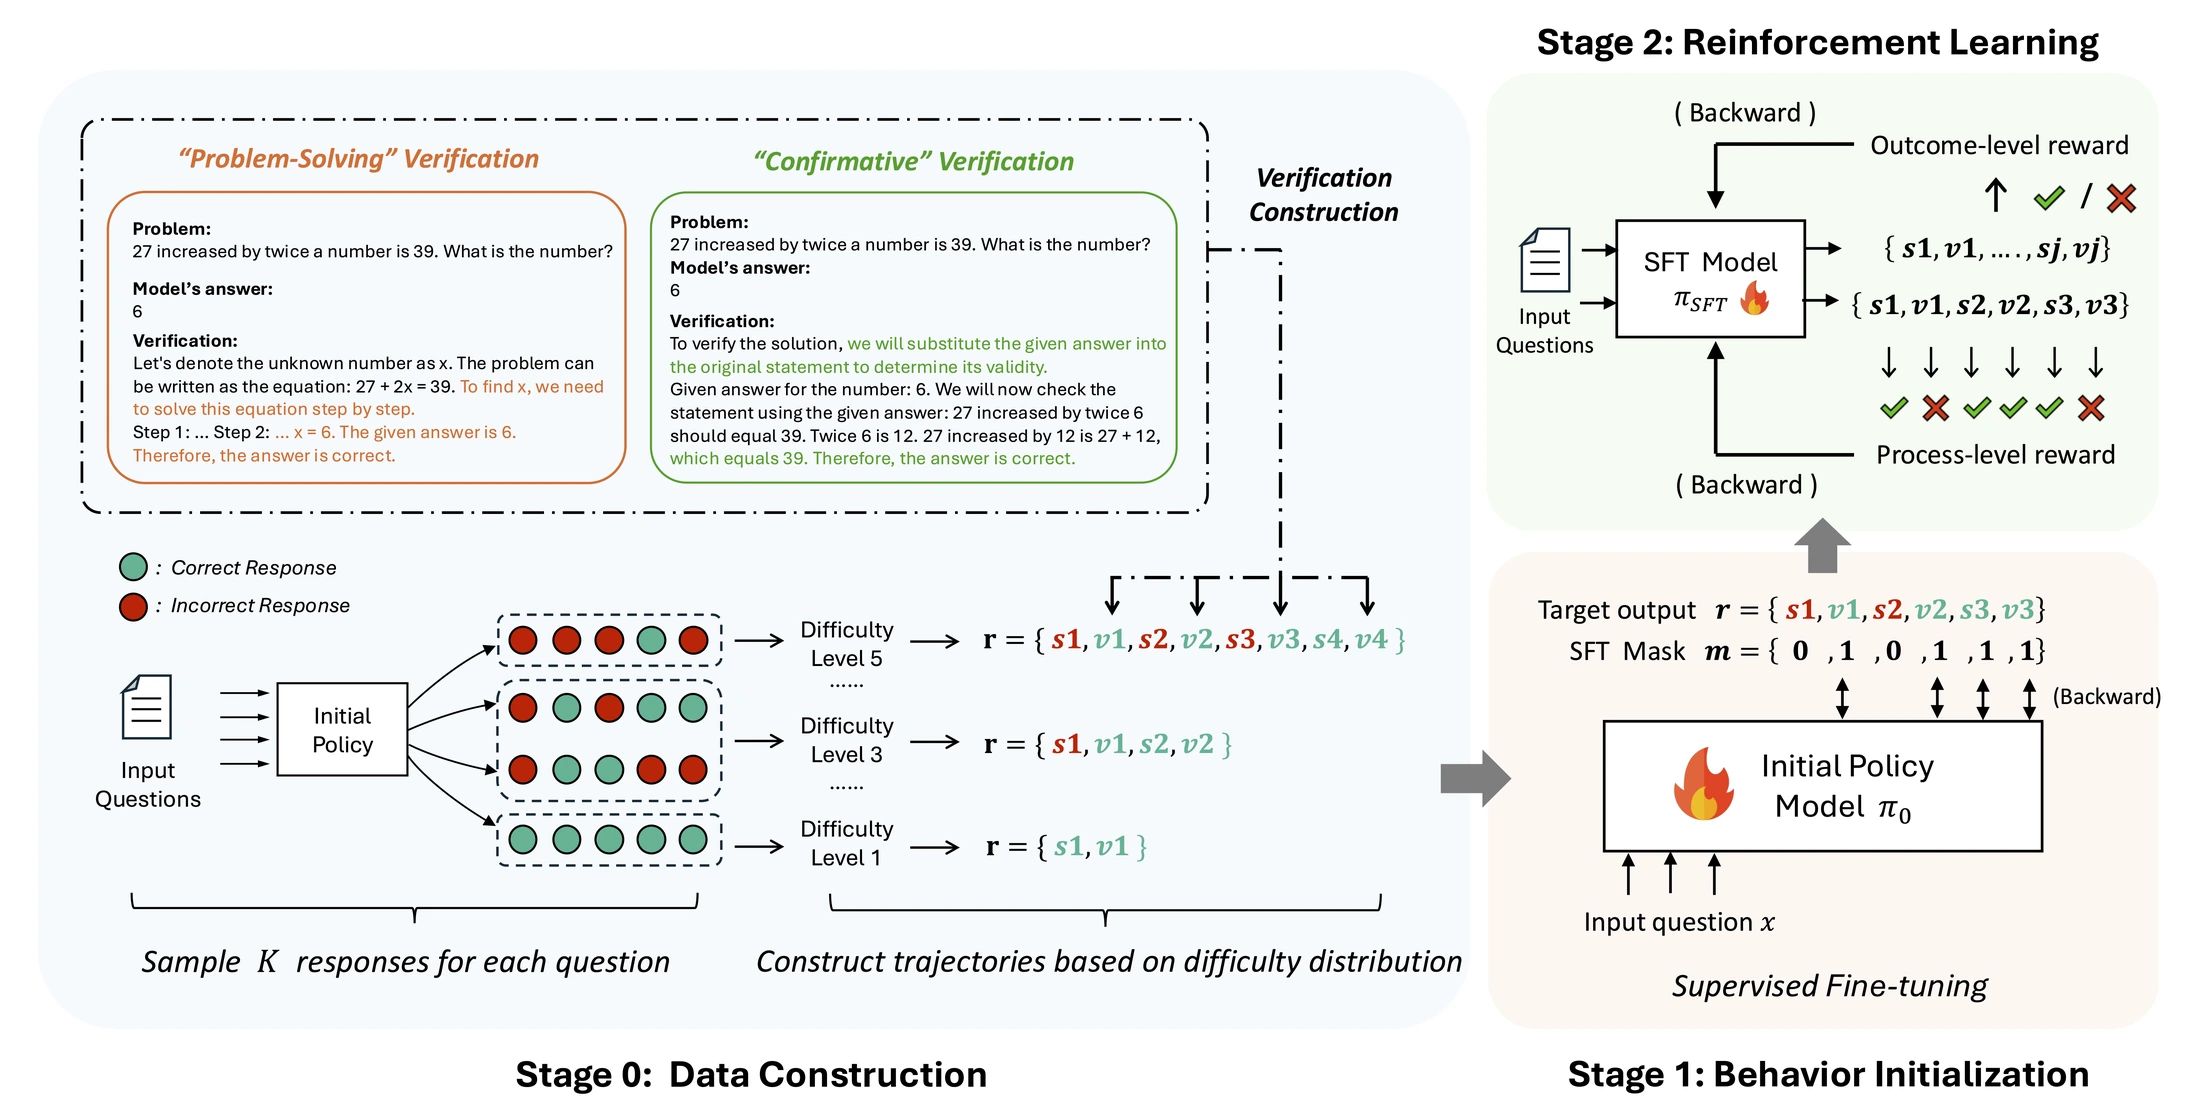
采样解答并构造验证过程,保留难度不同、尝试次数不同的训练轨迹。
通过监督微调学习求解、验证与修正之间的衔接。
采用规则奖励,分别研究最终结果反馈与过程反馈的作用。
在论文的 Qwen2.5-Math-7B 设置下,约 3.1k 条行为初始化样本使 MATH500 准确率从 51.0% 提升到 81.6%。这对应监督微调后的 BI 阶段;论文另行报告结果级和过程级强化学习后的成绩。
上述数值对应 MATH500,不是全部评测的平均分,也不是仅靠 RL 得到的提升。研究同时评测域内与域外任务,并比较不同基础模型的表现。