找到关键进展
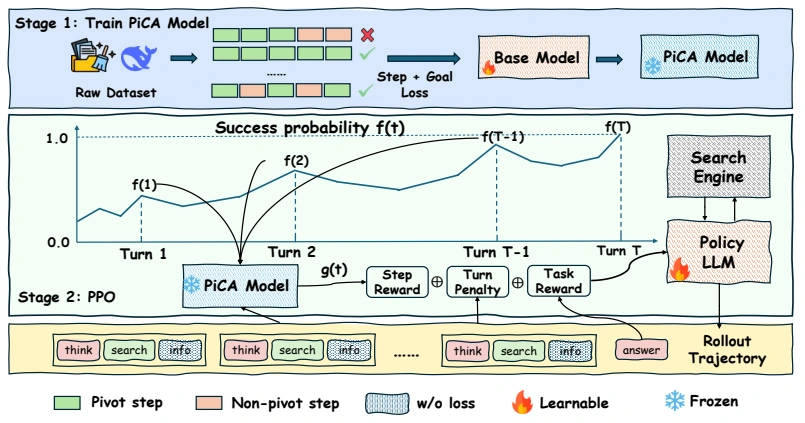
利用目标子问题与子答案,识别轨迹中推动任务求解的关键步骤,为奖励模型提供监督。
知识密集型问答 · 域内与域外评测
Qwen2.5-3B · 七项基准平均
Qwen2.5-7B · 七项基准平均
数据来源:论文 Table 1;EM 为答案精确匹配率,结果为三次独立运行的平均。
把搜索轨迹视为累积信息、逐渐接近正确答案的过程。
利用目标子问题与子答案,识别轨迹中推动任务求解的关键步骤,为奖励模型提供监督。
根据此前的搜索与推理估计成功概率,用相邻步骤的概率变化衡量进展,建模步骤之间的依赖。
结合过程奖励、搜索轮次惩罚与最终答案奖励,通过 PPO 优化 Agent 的多轮搜索策略。
覆盖 NQ、HotpotQA、TriviaQA、PopQA、2WikiMultiHopQA、MuSiQue 与 Bamboogle。
| 模型 | 方法 | EM ↑ | F1 ↑ |
|---|---|---|---|
| Qwen2.5-3B Instruct | TIPS | 33.6% | 41.1% |
| PiCA | 39.6% | 48.1% | |
| Qwen2.5-7B Instruct | TIPS | 41.7% | 51.0% |
| PiCA | 42.6% | 51.2% |
来源:论文 Table 1(EM)与 Table 2(F1)。原表 0–1 分数换算为百分数;TIPS 为主表中七项平均成绩最高的对比方法。上述结果限于论文中的搜索问答设置。
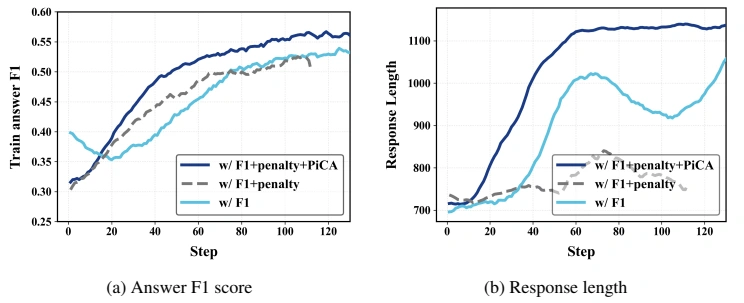
在论文的消融实验中,仅在答案奖励上增加轮次惩罚,会出现回答变短、后期性能下降的现象。加入 PiCA 后,训练保持较稳定的回答长度,答案 F1 持续提升。
围绕可验证任务、过程奖励与训练评测,探索 Agent 能力提升。