构建 GraphSilo
由算法轨迹与蒙特卡洛采样产生多样化解答,提供细粒度的正确与错误标签。
Rewarding Graph Reasoning Process makes LLMs more Generalized Reasoners
最终答案正确,并不意味着每一步推理都可靠。GraphPRM 利用图算法与自动标注构建过程监督数据,让奖励模型能够评估中间步骤,并将反馈用于搜索与模型训练。
图任务提供了明确的结构和算法规则。研究结合任务导向的算法轨迹与蒙特卡洛方法,生成推理过程和步骤标签,形成 GraphSilo;随后以这些标签训练 GraphPRM,判断推理步骤是否沿着正确方向推进。
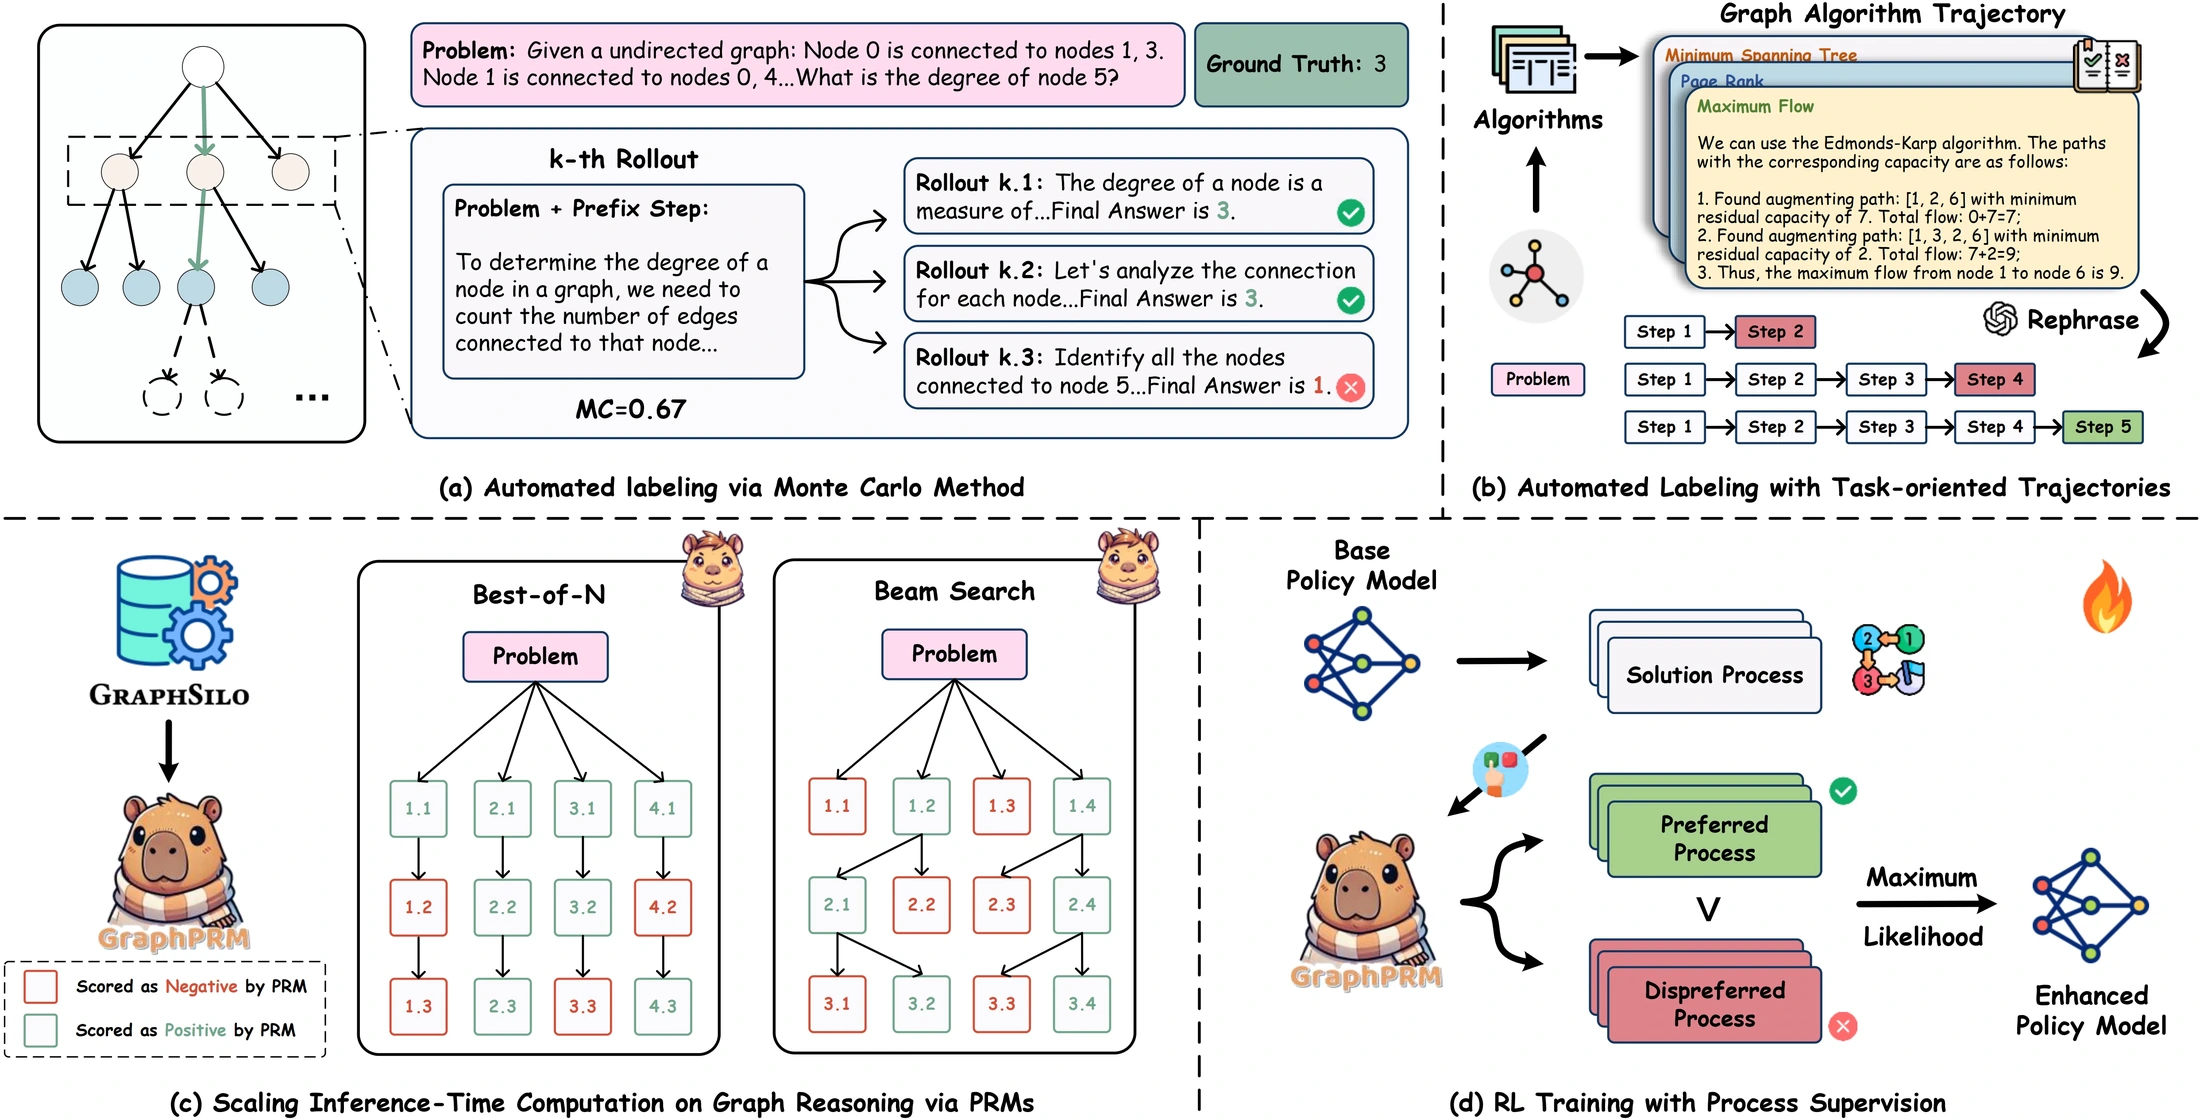
由算法轨迹与蒙特卡洛采样产生多样化解答,提供细粒度的正确与错误标签。
对中间推理步骤进行监督,让 GraphPRM 学习评估过程质量。
将评分用于 Best-of-N、Beam Search,以及构建偏好数据进行 DPO。
论文在 13 项图推理任务上评测,并进一步观察对新图任务以及 GSM8K、MATH500 等数学任务的迁移。它展示了自动生成的图推理过程监督可用于推理时搜索,也能为偏好优化提供训练信号。
118,189 为问题—解答样本数,并非独立问题数;394,165 为步骤级标签数。数据统计见论文 §3.1.4 与 Table 9,结果需结合基础模型和推理预算理解。