Benchmarks
用真实问题,
看清模型能力的边界。
从 Coding Agent 与记忆,到图推理、科学预测和领域语言。
选择一项研究,了解任务设计、评测方法与实验发现。
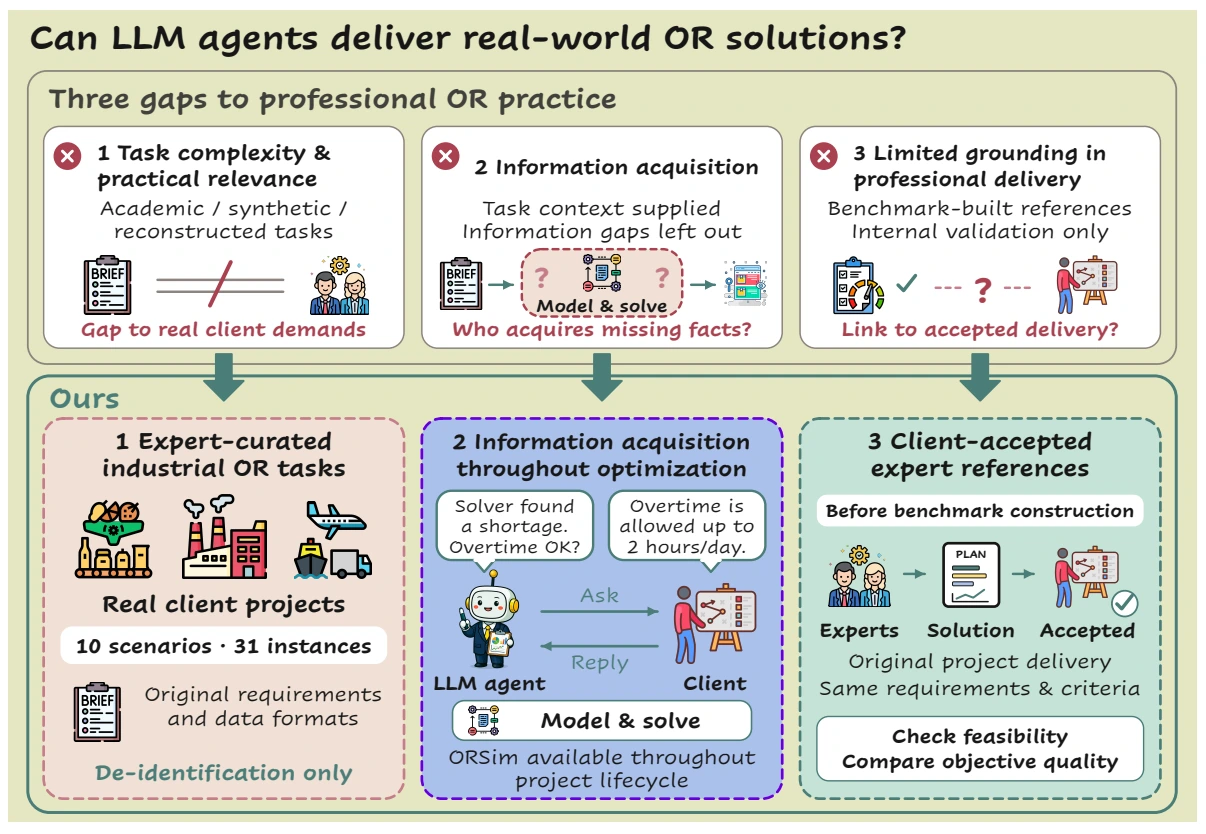
OR-License
Evaluating LLM Agents as Real-World Operations Research Practitioners
从原始客户需求与数据出发,Agent 能否交付可行的运筹优化方案?通过 ORSim 澄清业务信息,检验最终方案的可行性,并对照客户已验收的专家方案。
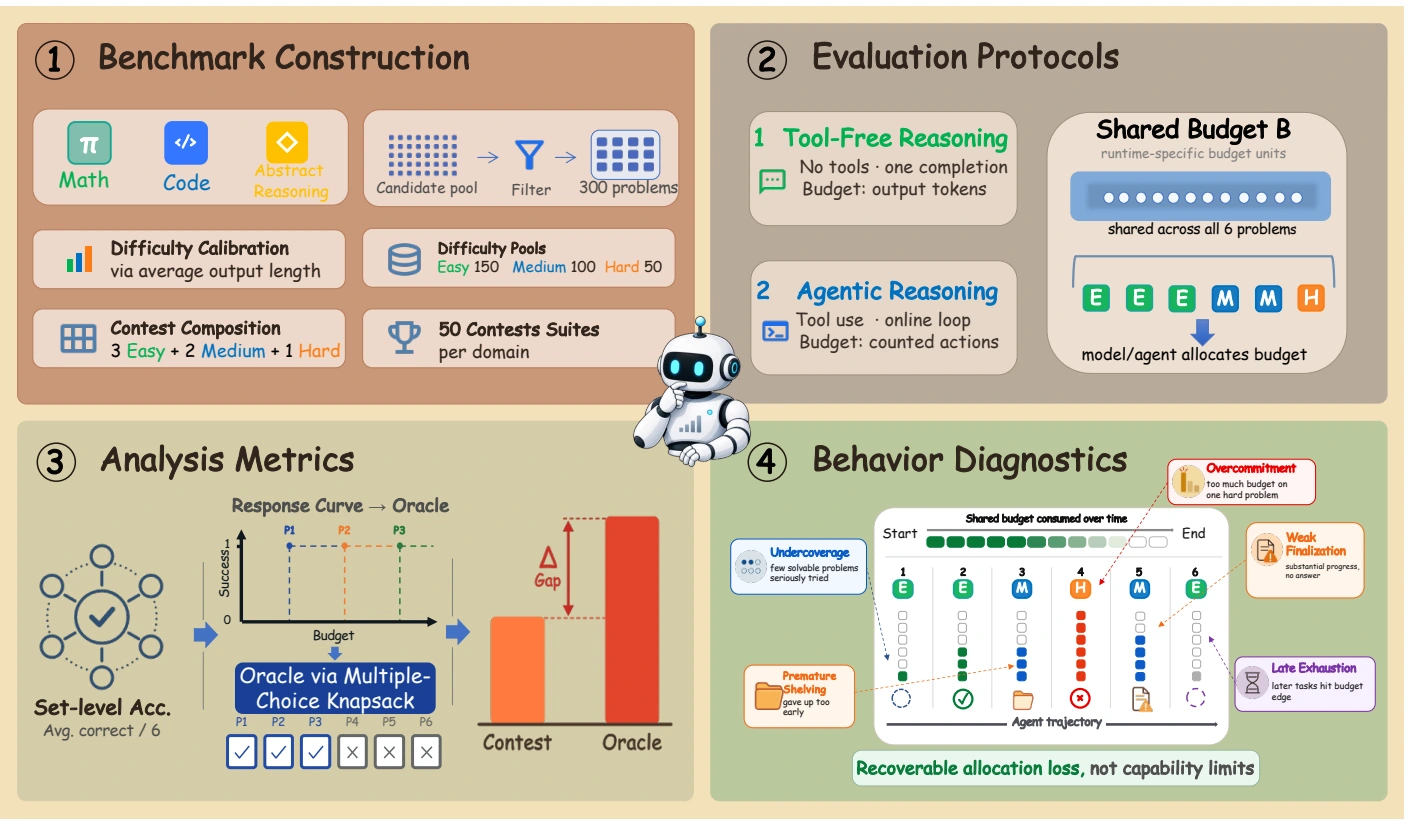
R³-Bench
LLMs Struggle with Resource-Rational Reasoning under Shared Budgets
当六道题共享一份预算,模型能否合理分配计算资源?R³-Bench 对照同一模型已展示的单题能力,评测跨任务的资源分配与策略调整。
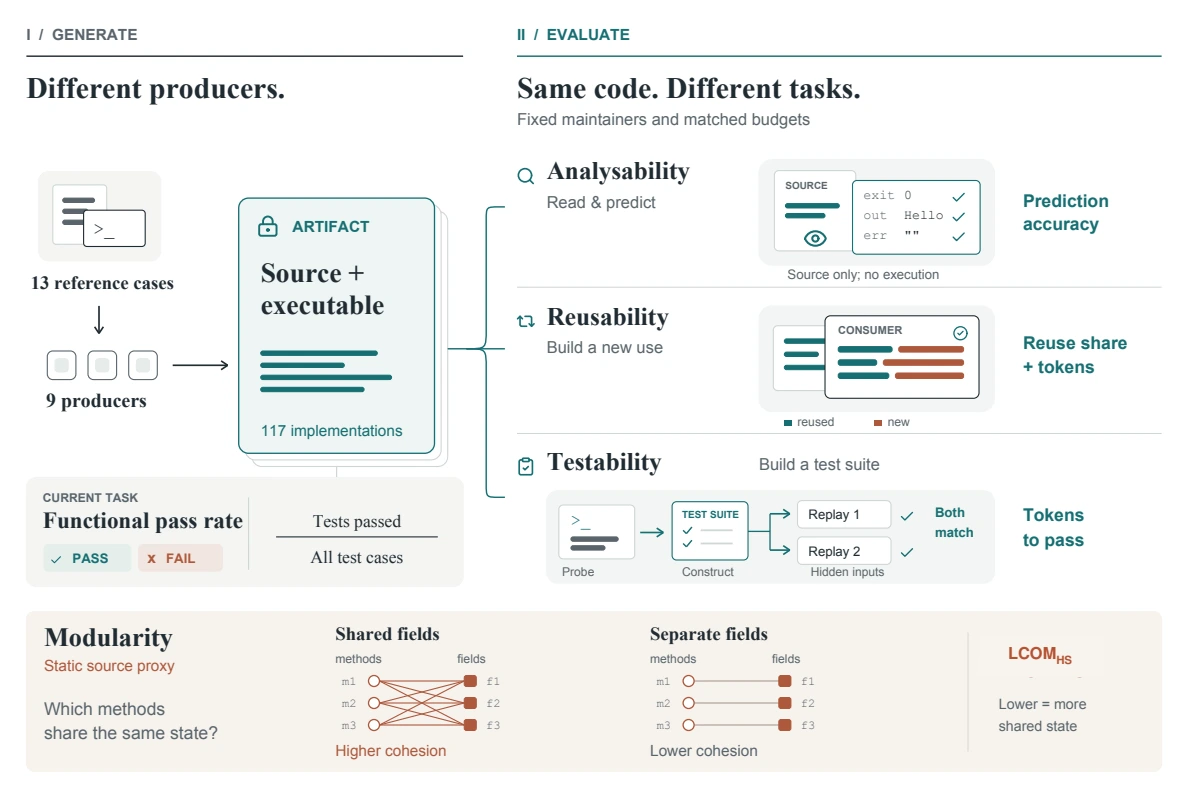
CarryBench
A Multi-Role, Multi-Maintainer Benchmark for the Maintainability of Agent-Generated Code
代码通过测试之后,下一位维护者还要付出多少工作?通过固定代码产物与维护者,分别评测可分析性、可复用性与可测试性。
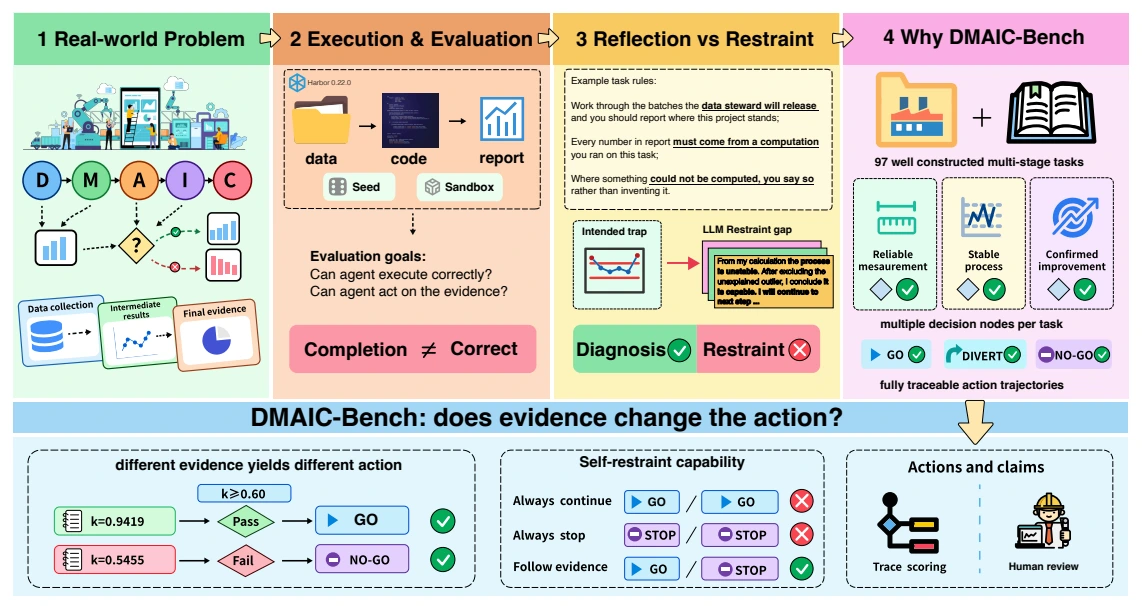
DMAIC-Bench
From Self-Reflection to Self-Restraint for Agents in Multi-Stage Analytical Tasks
当中间证据不支持继续分析时,Agent 能否真正改变下一步行动?用工业统计流程与配对反事实任务,区分正确继续、转向和停止。
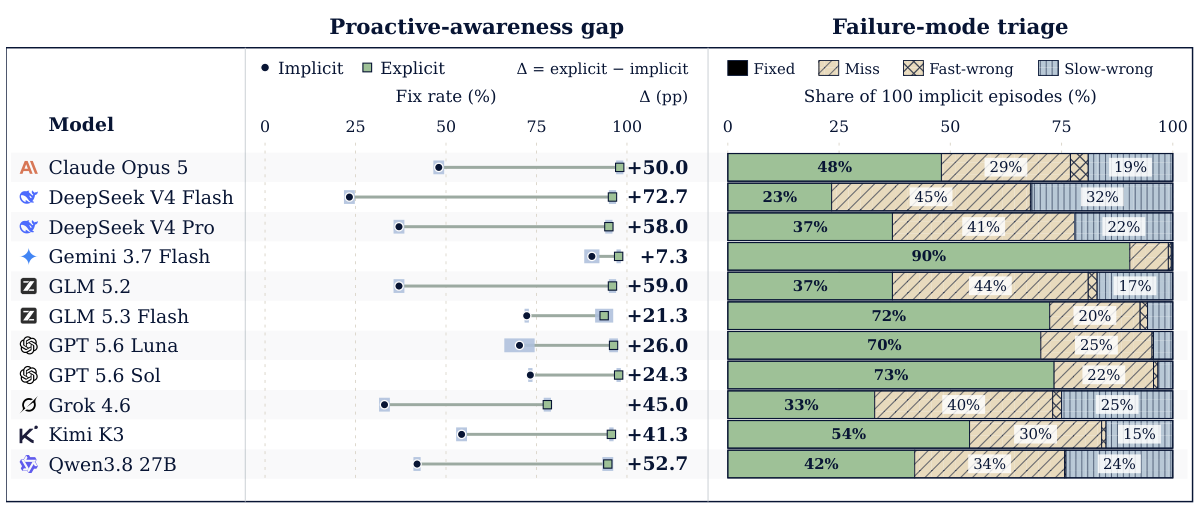
CrawlBench
When Code Crawls: Benchmarking Proactive Optimization in Coding Agents
评测 Coding Agent 能否主动发现并优化慢代码,比较主动修复率、能力差距与不同性能问题下的表现。
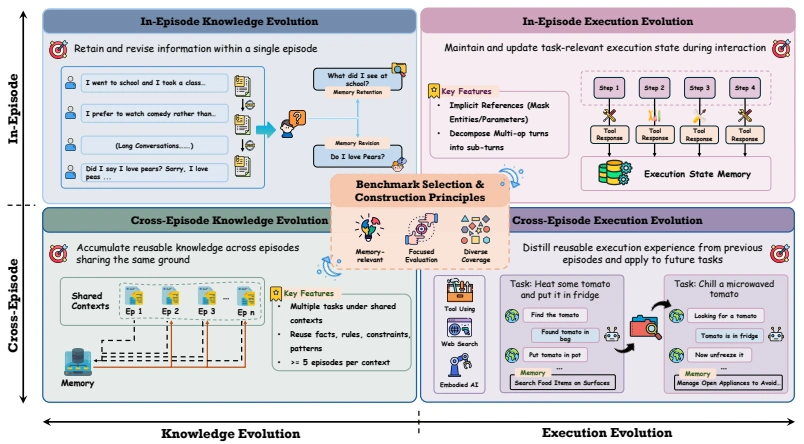
EvoMemBench
Benchmarking Agent Memory from a Self-Evolving Perspective
沿单次任务内 / 跨任务、知识 / 执行两条轴线评测四类记忆能力。覆盖 6 组评测数据集,在统一协议下比较 15 种记忆方法与长上下文基线。
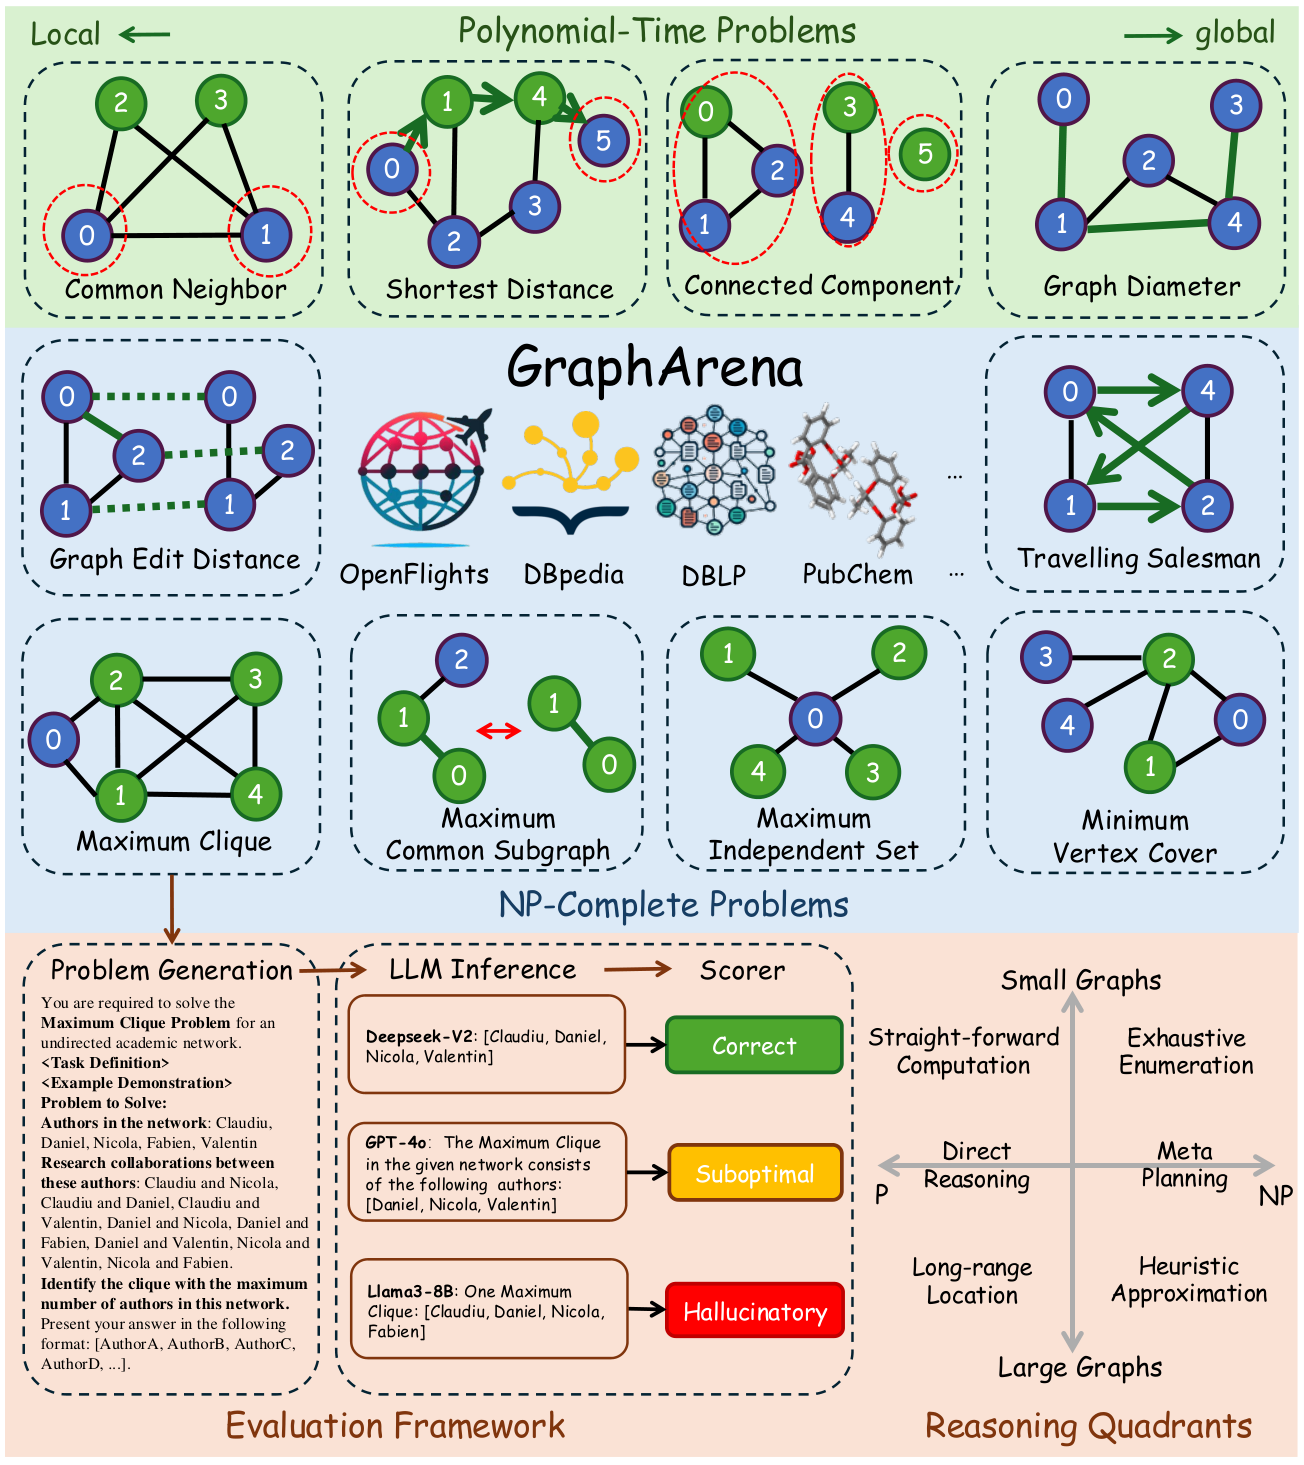
GraphArena
Evaluating LLMs on Graph Computation
10 项图计算任务,覆盖多项式时间与 NP-complete 挑战。
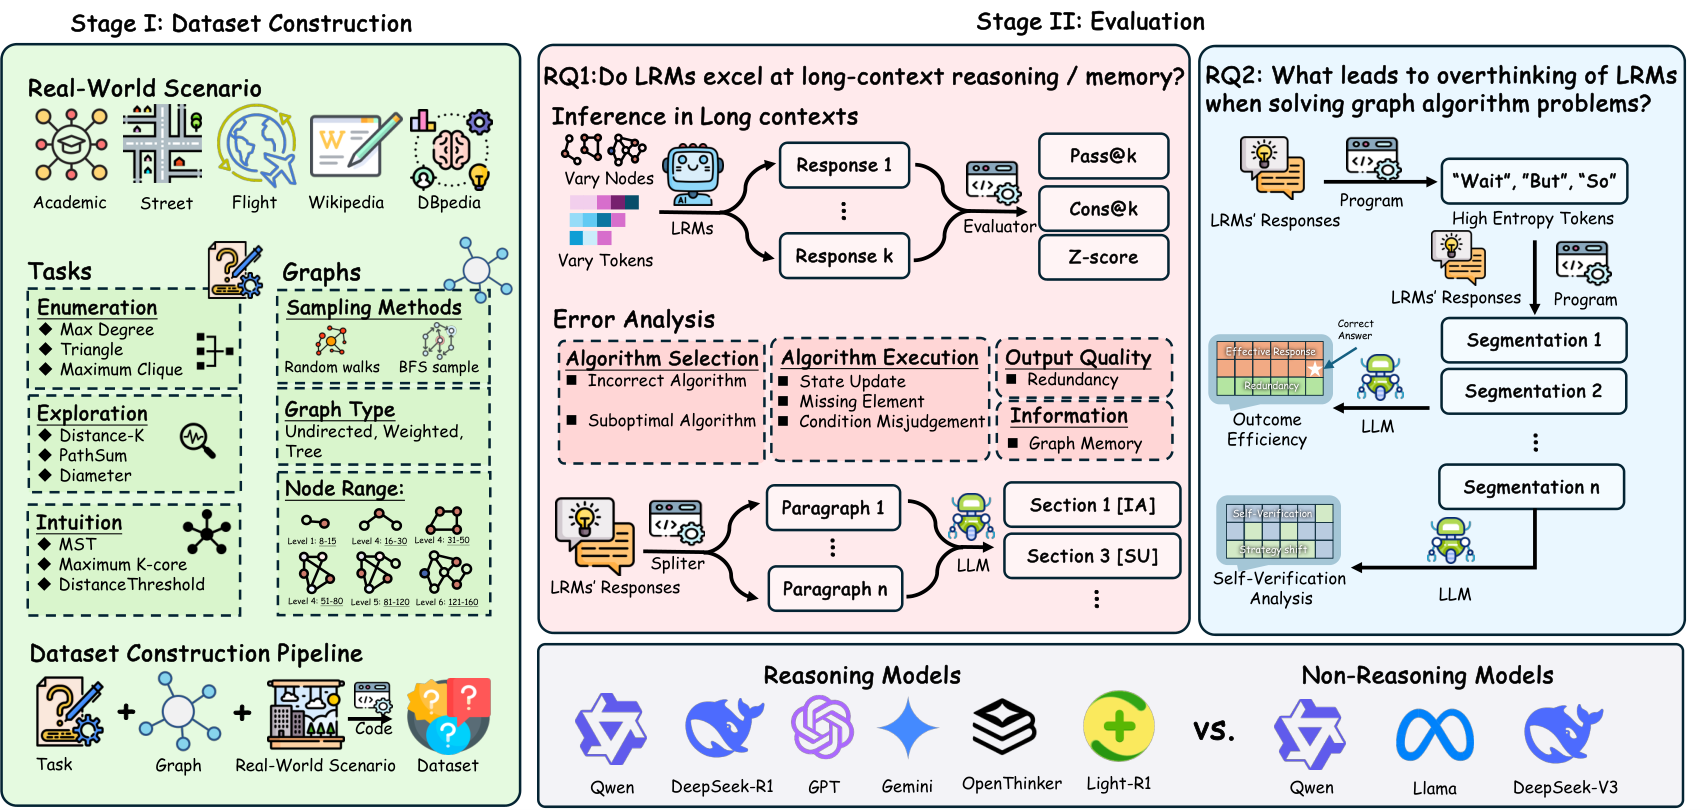
GrAlgoBench
Exposing Weaknesses of Large Reasoning Models through Graph Algorithm Problems
9 类图算法任务,覆盖多级难度,观察长上下文与过度思考。
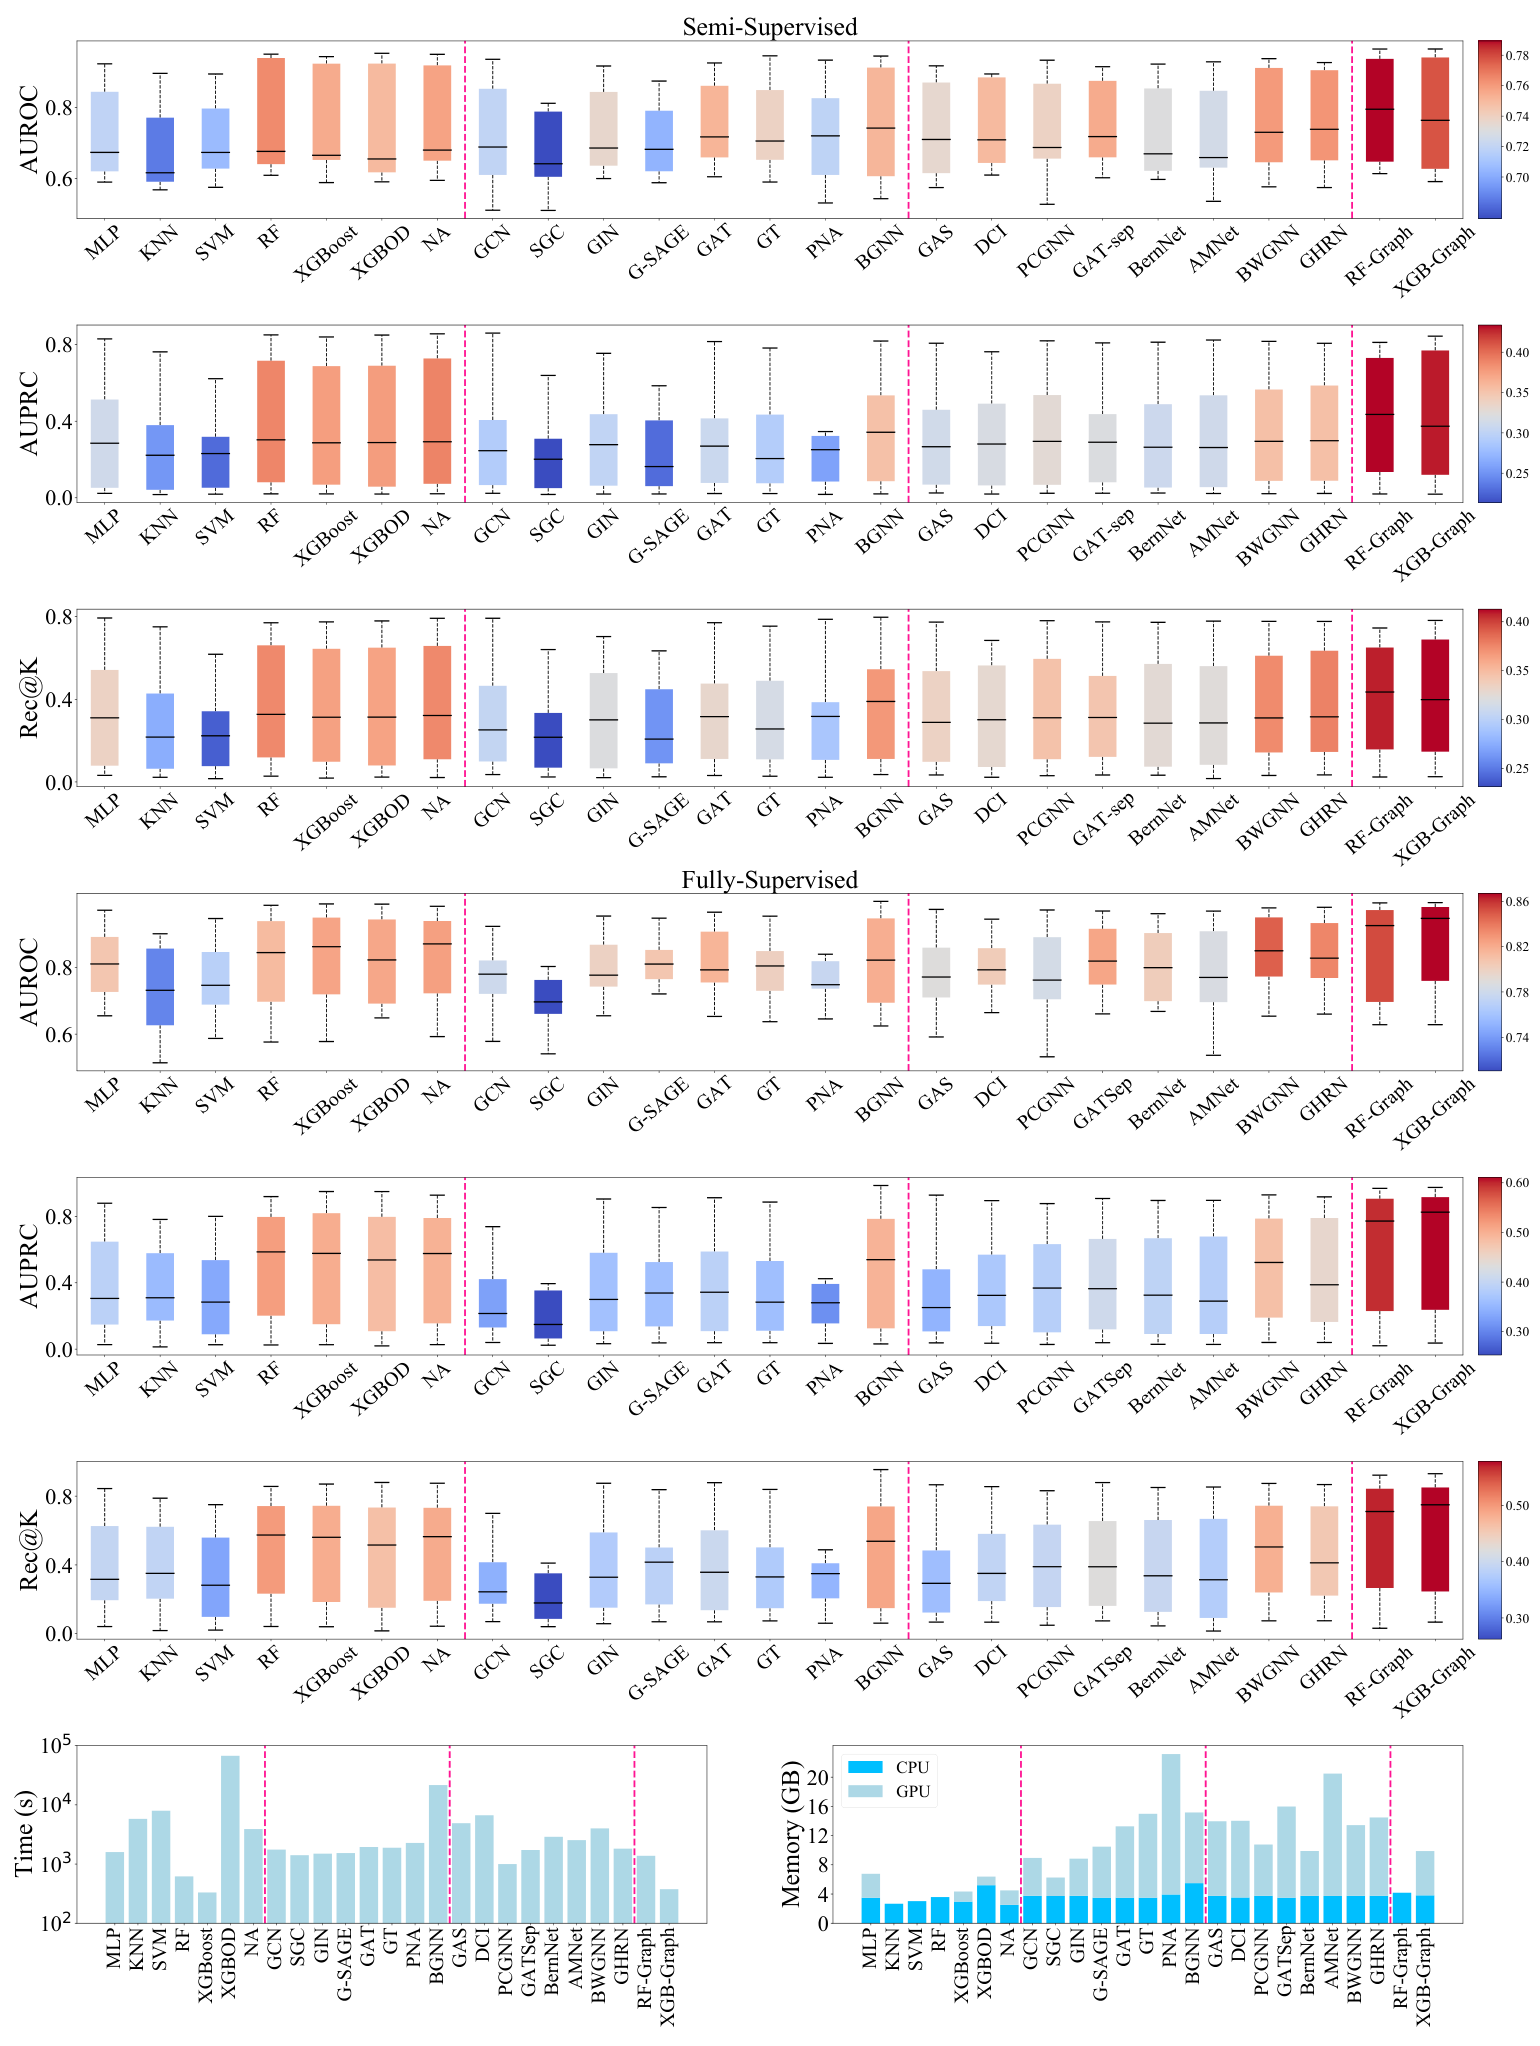
GADBench
Supervised Graph Anomaly Detection
10 个真实图异常检测数据集与 29 类模型。
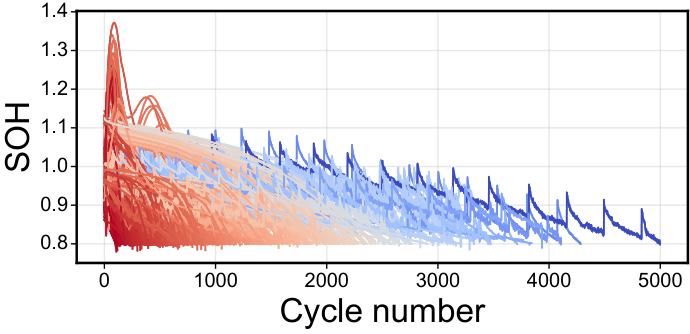
BatteryLife
Battery Life Prediction
整合 16 个数据集,覆盖多种电池格式、化学体系与充放电协议。
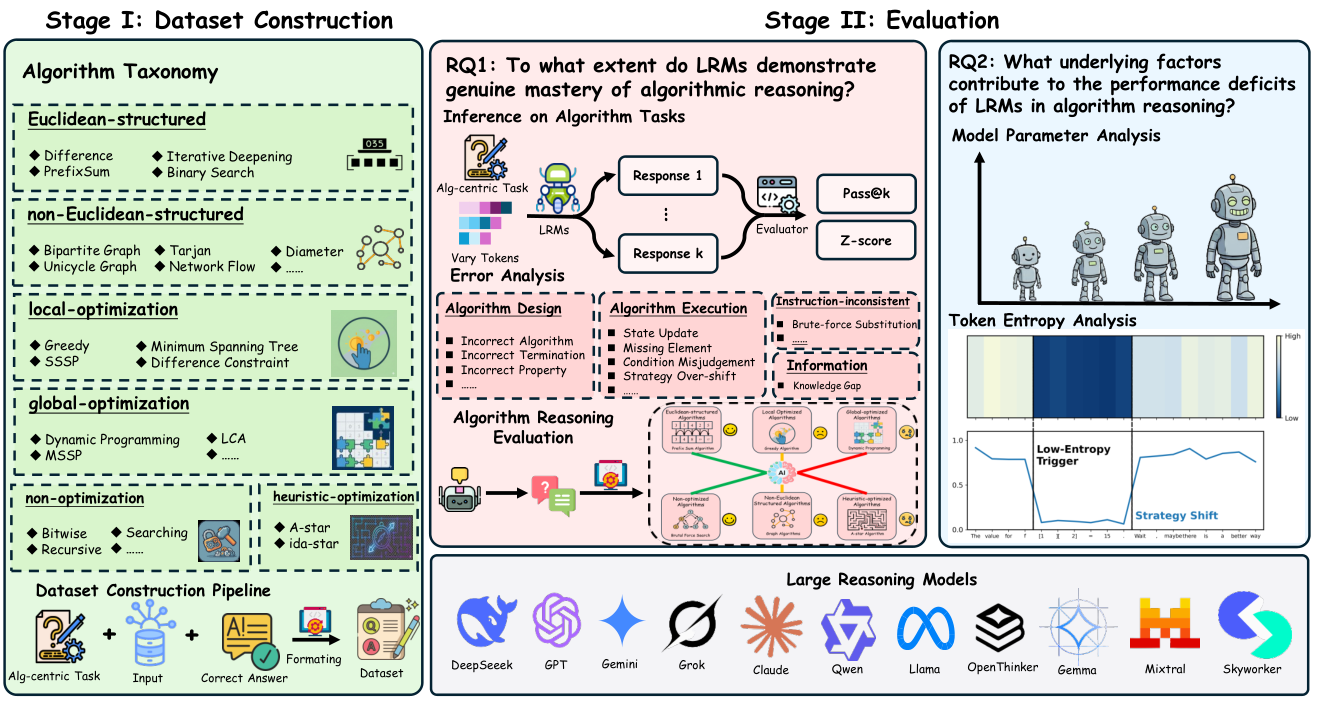
AlgBench
Understanding Algorithms
3,000 多道原创题,覆盖 27 种算法,评估推理模型的算法理解。
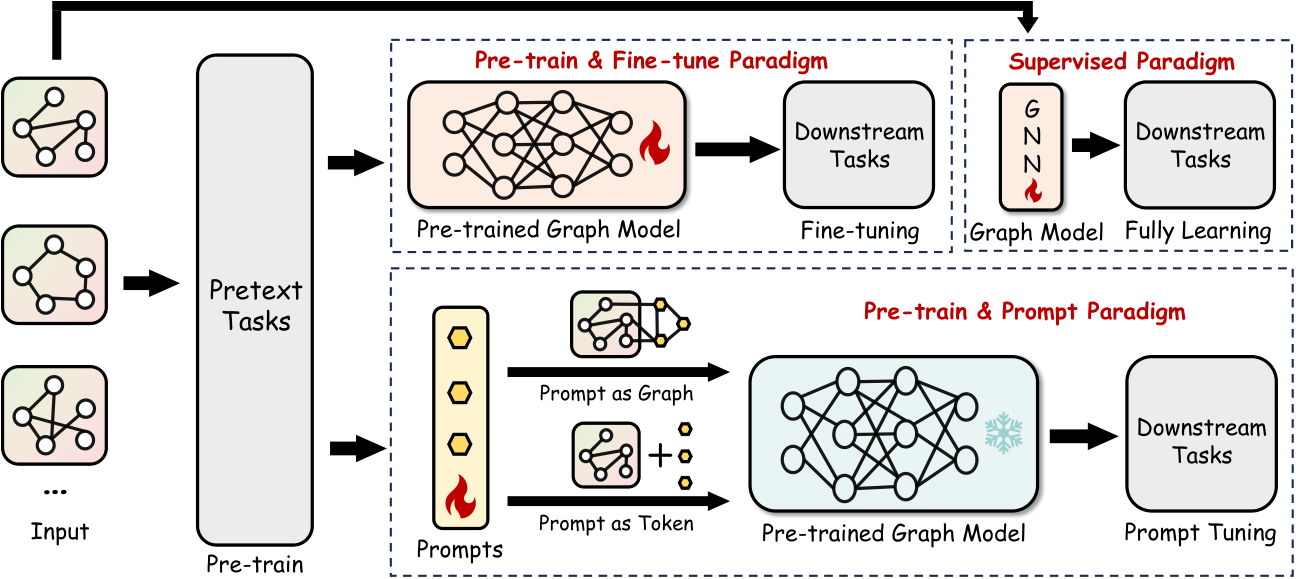
ProG
A Graph Prompt Learning Benchmark
组合 6 种预训练方法、5 种 Prompt 方法与 15 个数据集。
GLBench
A Comprehensive Benchmark for Graph with Large Language Models
覆盖监督与 zero-shot 场景,统一比较 GraphLLM 方法与传统基线,评估大语言模型在图学习任务中的表现。
SimXRD-4M
Big Simulated X-ray Diffraction Data and Crystalline Symmetry Classification Benchmark
提供 4,065,346 条模拟粉末 XRD 图谱,覆盖 119,569 个晶体结构和 33 种模拟条件,用于晶体对称性分类。
BAG
Benchmarking Anomaly Detection on Dynamic Graphs
面向动态图异常检测,覆盖 10 个数据集与 25 类模型,系统比较不同模型在时间变化图结构中的检测能力。
Golden Touchstone
A Comprehensive Bilingual Benchmark for Evaluating Financial Large Language Models
中英文金融 LLM 综合 Benchmark,覆盖 8 类金融 NLP 任务,用于评估金融知识、理解、推理与生成能力。
ProbTS
Benchmarking Point and Distributional Forecasting across Diverse Prediction Horizons
统一评测点预测与分布预测,覆盖多种时间序列、预测跨度与不确定性建模设置。
Orca
A Few-shot Benchmark for Chinese Conversational Machine Reading Comprehension
中文对话式机器阅读理解 Benchmark,包含 831 段对话、4,742 个对话轮次,覆盖 33 个领域与 few-shot 泛化设置。