生成可执行规格
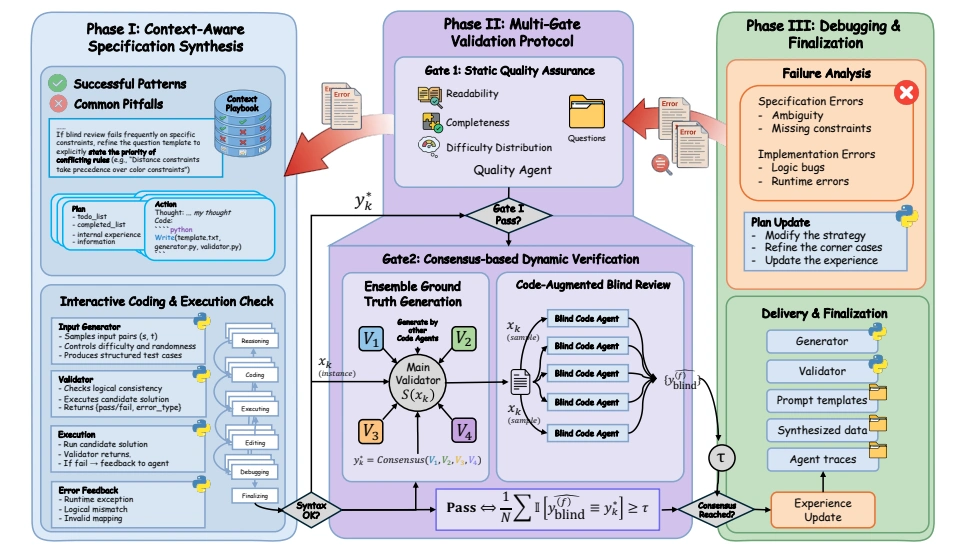
以结构化种子和历史经验为起点,编写生成器、验证器与题面模板;通过执行检查修复语法和运行时错误。
Scaling the Scaling Logic: Agentic Meta-Synthesis of Logic Reasoning
把可演化的对象推进到任务规则本身。Agent 在“生成—验证—修订”闭环中,编写可执行的生成器与验证器,持续扩展用于 RLVR 的逻辑训练任务。
一个任务族包含生成器(Generator)与验证器(Validator)。生成器定义题面、规则与难度;验证器通过程序检查候选答案。SSLogic 让 Agent 修改这套可执行规格,从而产生新的逻辑结构与约束组合。
以结构化种子和历史经验为起点,编写生成器、验证器与题面模板;通过执行检查修复语法和运行时错误。
先检查格式、可读性和完整性,再由独立求解器形成答案共识;盲审 Agent 仅看到题面,通过编程求解检验题目。
将歧义、缺失约束和实现错误反馈给主 Agent。通过验证后交付生成器、验证器、模板、数据与合成轨迹。
论文在 Qwen3-8B 系列上采用 GRPO,比较种子数据与演化数据。除了固定优化步数,还提供 Token 预算匹配和外部 Enigmata 数据上的规模控制实验。
| 评测 | Seed | Evolve | 变化 |
|---|---|---|---|
| SynLogic | 22.3% | 24.3% | +2.0 pp |
| BBH | 61.8% | 67.3% | +5.5 pp |
| BBEH | 16.3% | 17.2% | +0.9 pp |
| AIME25 | 11.5% | 16.4% | +4.9 pp |
| Math500 | 83.6% | 82.7% | −0.9 pp |
指标为 pass@1;训练 240 步,Seed / Evolve 实例数为 8,776 / 8,758。pp 表示百分点。数值取自论文 Table 2C,并非所有评测都提升。
累计 RL Token 约 1.09B 时,Evolve 的宏平均准确率相对 Seed 高 7.3%(论文 Figure 5 / Appendix N)。
KORBench 的逻辑与操作类别分别提升 13.2 和 9.6 个百分点,拼图类别提升 1.2 个百分点(Table 4)。
100 条合成轨迹中,55 条通过完整验证;按该实验计算,每个被接受任务族的摊销成本约 1.18 美元(§5.4)。
这项工作展示了利用 Agent 自动扩展可验证任务族的路径:让数据生产同时具备生成规则、可执行验证和反馈修订能力。
当前验证集中在逻辑与数学推理、Qwen3-8B 系列,并依赖已有的结构化任务种子。Token 预算匹配不等同于完整计算成本匹配;跨模型家族、代码生成及科学推理中的效果仍需进一步实验。