✳ CODE · SCIENCE · PHYSICAL AI
ALLE AI Lab
Assist LLM to Eat everything
Science 和 Physical AI 的 Coding Agent 训练与评测数商
面向模型公司、Research Labs 与软件团队
FEATURED BENCHMARK / ALLE RESEARCH
CrawlBench
没人提醒,模型会主动优化慢代码吗?
90%
73%
72%
70%
54%
48%
42%
37%
37%
33%
23%
主动修复率 / Implicit · 100 个主实验案例 · 11 个模型查看模型与指标 ↗ ICLR 2027 在审稿 · Figure 3 作者报告值,按原图取整
01 / DATA & ENVIRONMENTS
从训练数据,到真实能力。
可运行 · 可评分 · 可回放
为下一代 Agent 构建学习的世界。
01
Coding Agents
让 Agent 在真实代码库与工具链里,完成真正的工作。
SOFTWARE ENGINEERING · AGENT⌘
真实代码库中的
软件工程任务
围绕代码理解、缺陷修复与功能开发构建任务,将评测环境转化为可反复交互的 RL 环境。
01task → repository
02agent → implementation
03verifier → passed ✓
DeepSWE · SWE-bench Pro · Terminal Bench
RL AS A SERVICE · ENTERPRISE↗
企业工作流
与 Agent 训练环境
把软件操作、工具调用和多步骤业务流程组织成任务,为企业软件构建 Agent 的训练与评测入口。
真实任务→工具交互→结果验证
企业任务 · 工具调用 · 可验收交付
02
Science & Reasoning
从科学代码与工作流中,构建可验证的推理任务。
STEM · SCIENTIFIC CODE∑
源自真实科研的
科学任务数据
从科学代码库发现任务种子,构建可执行任务,并结合程序验证与科学有效性检查,形成训练数据。
仓库发现 · 任务合成 · 多重验证
EVALUATION · VERIFIABLE REASONING◎
把科学能力,
变成可测量的进步
围绕科学推理与代码执行构建评测,让任务、环境与验证器对齐,观察模型在真实科研工作中的表现。
SAB+14.6
BixMCQ+8.0
BioMystery+3.6
Qwen 27B · SFT 后 pass@1 提升(pp)
03
Physical AI
连接仿真与真实世界,让智能具备行动的能力。
ROBOTICS · ALLE-R4⌁
可回放、可评分的
具身任务
覆盖真实机器人的动作、观测、成功与失败判定。以任务集与评测环境,连接数据、训练和真机验证。
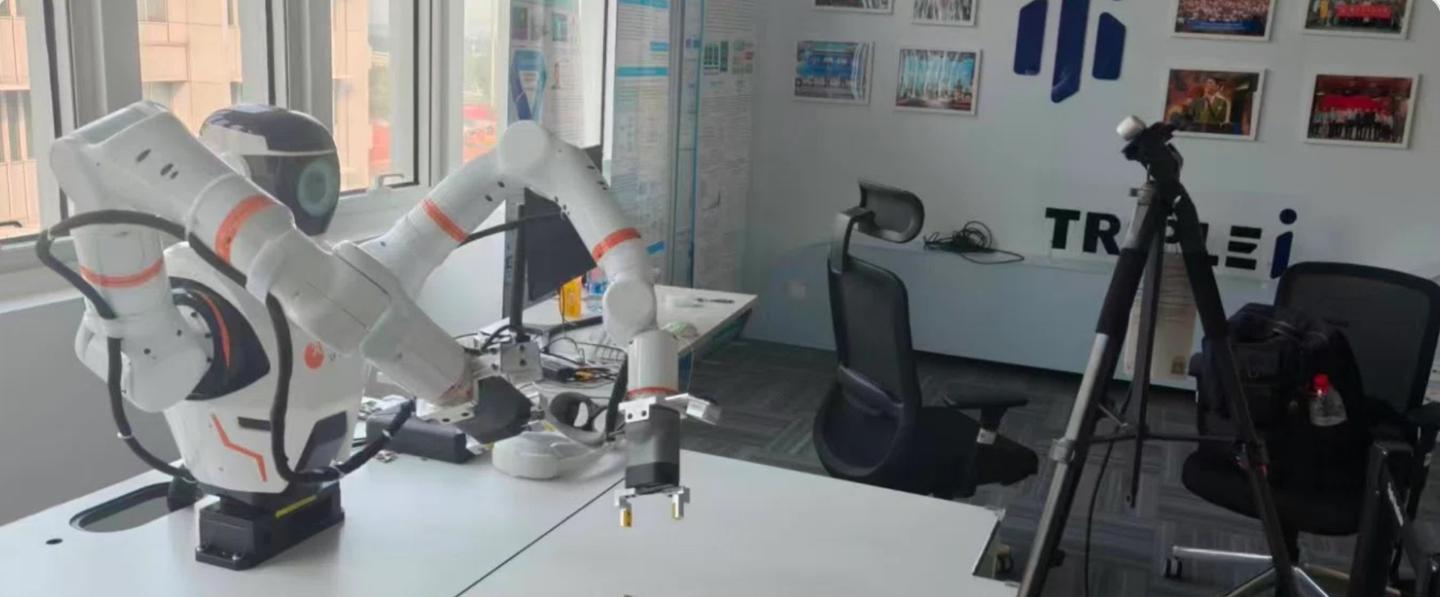 FROM SIMULATION TO REALITY
真机执行轨迹 · 任务集 · Harness
为你的模型找到合适的任务与环境。
02 / BUILT TO BE VERIFIED
每一次进步,
都有据可循。
用真实任务检验能力,用可复现的过程建立信任。
数据、环境与评测,共同构成训练的闭环。
了解我们的交付方式 ↗科学任务,经过训练验证。
同一模型在不同科学评测中的 pass@1 提升
数据来源:ALLE AI Lab BP,科学数据管线实验。数值为 SFT 后 pass@1 的百分点增量;不同模型与任务的结果不可直接等同。