REASONING / SHARED BUDGETS
R³-Bench
LLMs Struggle with Resource-Rational Reasoning under Shared Budgets
当六道题共享一份预算,模型能否合理分配计算资源?R³-Bench 对照同一模型已展示的单题能力,评测跨任务的资源分配与策略调整。
3任务领域
6每组问题数
50每领域任务组
01 / RESEARCH OVERVIEW
评测问题
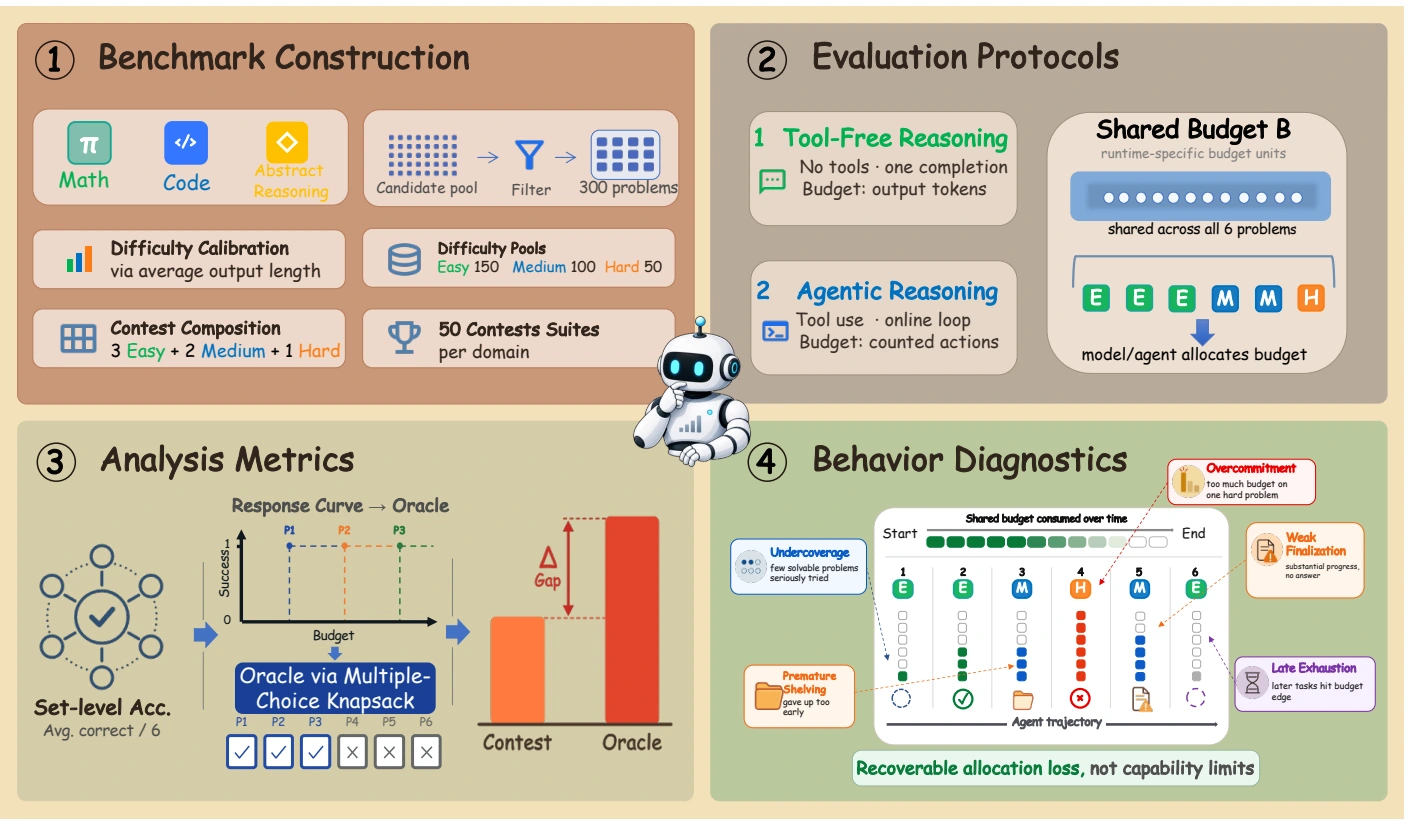
单题能解出来,不代表共享预算下能实现同样的能力。R³-Bench 考察模型如何选择问题、分配计算投入,以及何时继续、切换或停止,将解题能力与资源分配表现区分开。
02 / RESEARCH OVERVIEW
共享预算的任务设计
覆盖数学、竞赛编程和抽象推理三个领域。每个领域从 300 道题构建 50 组六题任务,每组包含 3 道低资源需求、2 道中等需求和 1 道高需求题。无工具设置以输出 Token 计预算,Agent 设置以计数动作计预算;强压力与中等压力分别对应模型自身基线资源用量的 20% 和 80%。
03 / RESEARCH OVERVIEW
同一模型的能力参照
匹配的单题实验建立预算—成功率响应曲线,并构造均等分配回放与离线经验 Oracle。Oracle 在同一总预算内选择各题的预算档位,作为已观察单题能力的分配参照。它使用离线信息,不是可直接部署的在线策略,也不代表理论上的能力上限。
04 / RESEARCH OVERVIEW
主要发现
主表覆盖 6 个模型、两种设置、两档预算压力和三个领域,共 72 个组合。Oracle 均值在所有组合中不低于实际共享预算表现,其中 71 个组合严格更高。中等压力、无工具设置下,均等分配回放也超过了 6 个模型中的 3 个。增加预算或开放工具并未一致消除差距。
05 / RESEARCH OVERVIEW
从执行轨迹理解差距
强压力下,模型更常因预算花在其他问题上而错过可解题;中等压力下,则更常在已有部分进展后停止。三模型的强压力 Agent 诊断中,固定调度器在 9 个模型—领域组合中的 6 个超过原始任务均值,但没有一种策略在所有领域占优。
内容与实验结果据论文原文整理,结果对应文中模型与评测协议。
浏览全部 17 项 Benchmark ↗