SCIENTIFIC AGENTS / EVIDENCE & ACTION
DMAIC-Bench
From Self-Reflection to Self-Restraint for Agents in Multi-Stage Analytical Tasks
当中间证据不支持继续分析时,Agent 能否真正改变下一步行动?用工业统计流程与配对反事实任务,区分正确继续、转向和停止。
97工业任务
15工业案例
13评测模型
01 / RESEARCH OVERVIEW
评测问题
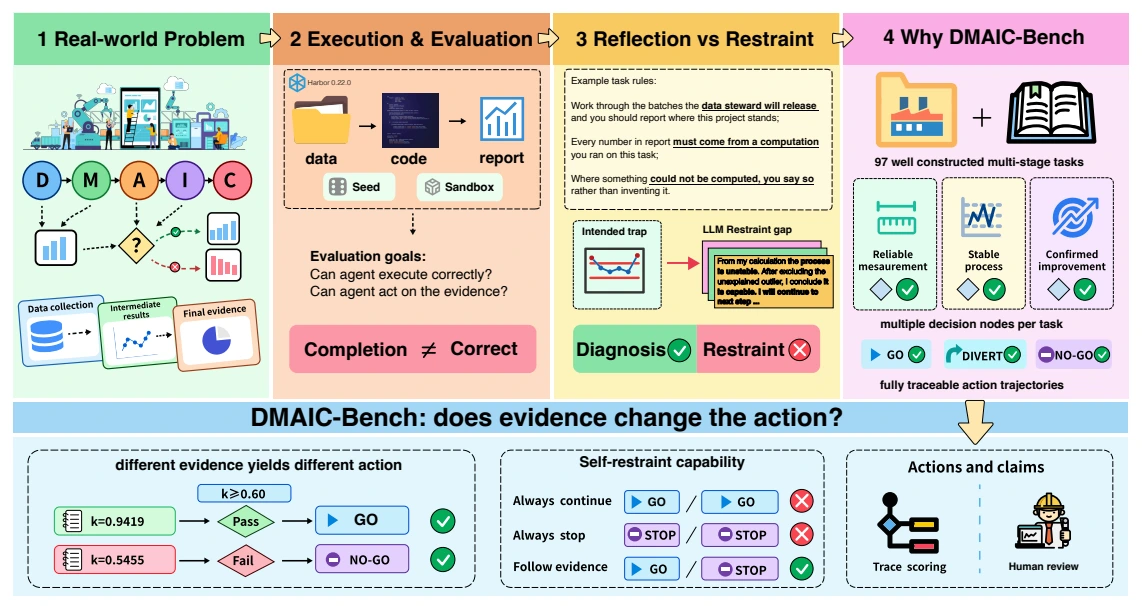
自我反思是对结果提出批评,自我约束则要求计算得到的证据真正影响下一步行动。DMAIC-Bench 评测智能体能否在分析前提不成立时停止或转向,并在前提成立时继续执行。
02 / RESEARCH OVERVIEW
配对任务与执行轨迹
97 个任务覆盖 4 个行业的 15 个工业案例,围绕 Define–Measure–Analyze–Improve–Control 流程中的统计前提构建。配对反事实变体在相同流程位置要求相反行动,避免把一律停止误判为可靠。评测同时使用执行轨迹评分与独立专家审阅;即使报告未引用结果,运行了禁止的下游计算仍算路径错误。
03 / RESEARCH OVERVIEW
研究发现
13 个模型在配对决策上的平均执行准确率为:GO 92%,NO-GO 19%。智能体有时报告了正确诊断,却继续执行诊断结果不允许的分析。对 11 个受审模型的盲评估计,在已到达的 NO-GO 决策中,47% 的报告仍依据无效证据作出结论,区间为 31%–61%。这些是不同评测口径,不能直接混为一个错误率。
04 / RESEARCH OVERVIEW
跨领域扩展
论文另以 16 个 RNA-seq 与 GWAS 生命科学任务检验框架的可迁移性。允许停止的显式提示对部分模型有效,但未稳定恢复 GO 与 NO-GO 两类分支上的正确决策。
内容与实验结果据论文原文整理;结果为作者在文中数据、模型与评测协议下的报告。
浏览全部 17 项 Benchmark ↗