CODING AGENTS / MAINTAINABILITY
CarryBench
A Multi-Role, Multi-Maintainer Benchmark for the Maintainability of Agent-Generated Code
代码通过测试之后,下一位维护者还要付出多少工作?通过固定代码产物与维护者,分别评测可分析性、可复用性与可测试性。
13仓库级案例
9代码生成模型
3维护者配置
01 / RESEARCH OVERVIEW
评测问题
功能正确并不等于易于维护。CarryBench 将生成代码的模型与后续维护者分开,考察同一份冻结代码在不同维护任务中带来的工作难度。
02 / RESEARCH OVERVIEW
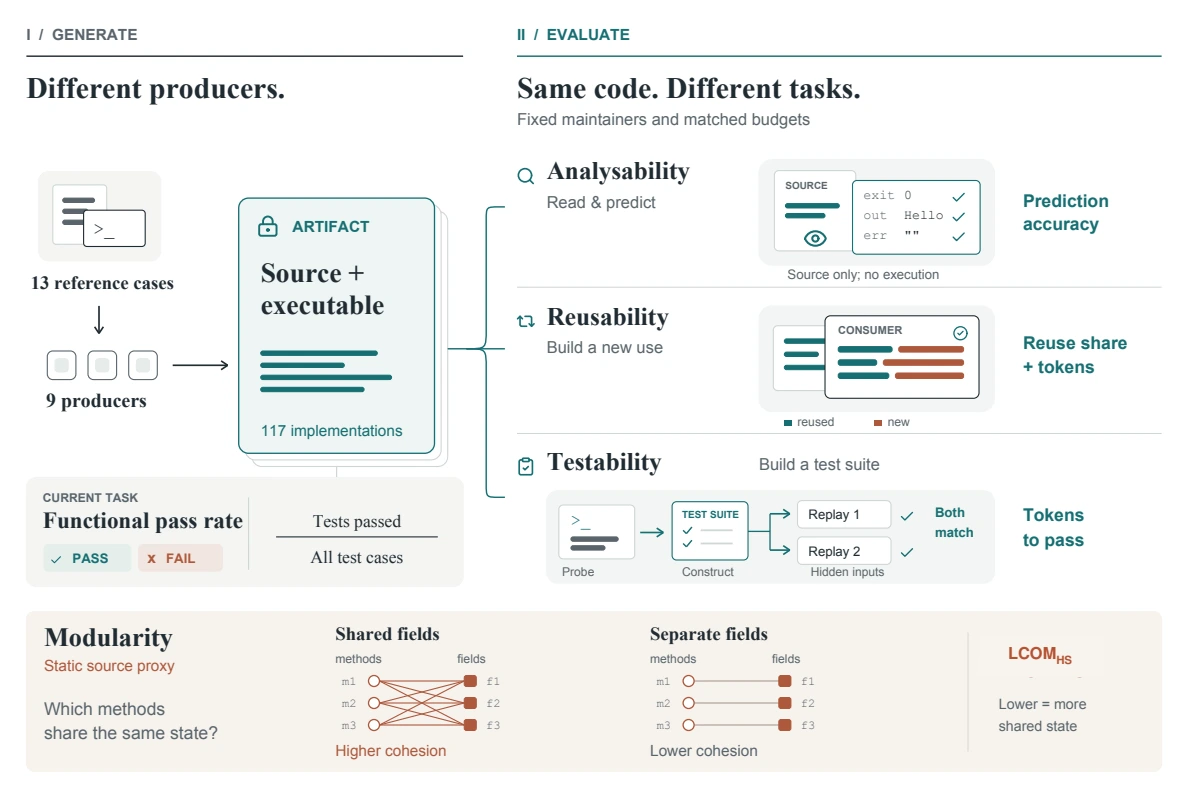
两阶段、多角色评测
第一阶段由 9 个模型在 13 个案例上生成 117 份实现,覆盖 Python、Go、Rust 和 C++。第二阶段在固定预算下,使用 3 种维护者配置:观察者只读源码预测行为,复用者基于既有代码构建新用途,测试者编写黑盒测试套件。静态模块性作为独立的结构代理指标。
03 / RESEARCH OVERVIEW
研究发现
不同维护需求会产生不同的模型排序。可复用性的排序在维护者之间相对更一致,可分析性与可测试性的一致性较弱。更高的状态内聚性也不一定意味着更容易完成下游工作,因此论文按任务和维护者分别报告结果,不合并为一个通用分数。
内容与实验结果据论文原文整理;结果为作者在文中数据、模型与评测协议下的报告。
浏览全部 17 项 Benchmark ↗