Research-grade data infrastructure

让模型能力
可训练、可测量、
可交付。

构建真实任务环境、Agent 轨迹与 Benchmark,沉淀可复用的能力资产。

CAPABILITY CALIBRATION / 01
01 任务环境
02 Agent 执行
03 轨迹与测试
04 能力资产
SystemBenchmark
ProtocolVerified
OutputReusable
Evidence first
10+Benchmark 项目
百万+数据订单机会
4-stage能力生产链
可复现任务与测试
Selected research / 01—03

从研究结果,
到实际应用。

我们把 Benchmark、交互环境与生成模型研究组织为可追溯的能力档案,帮助团队选数据、找回归、做验收。
Live research exhibition
Capability archiveComplete research frame
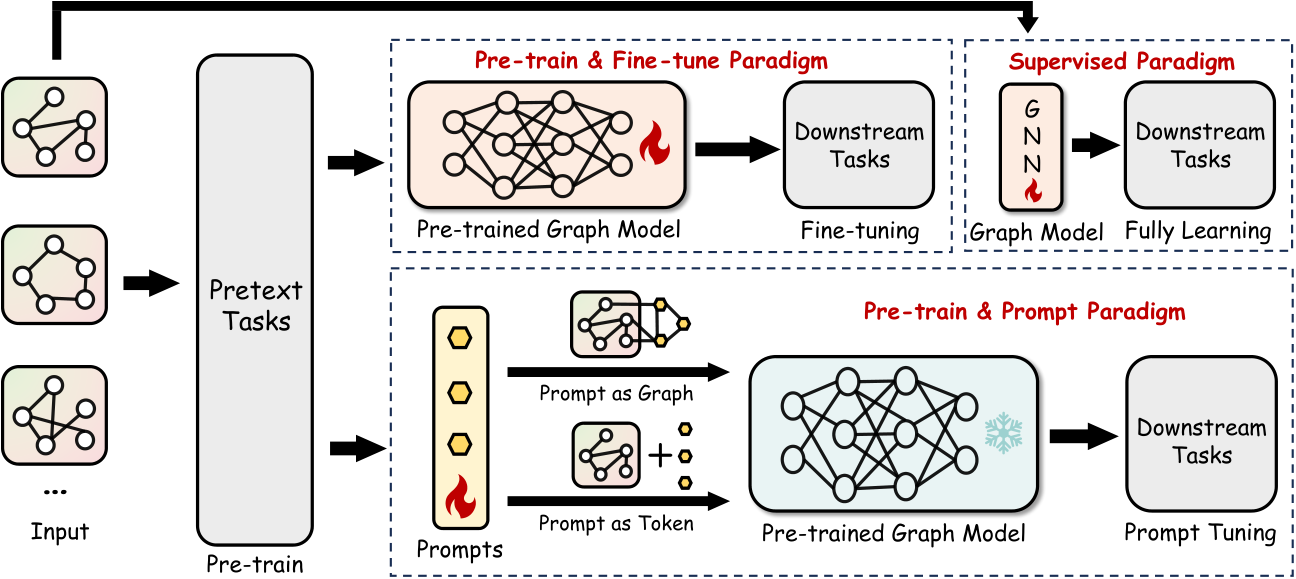
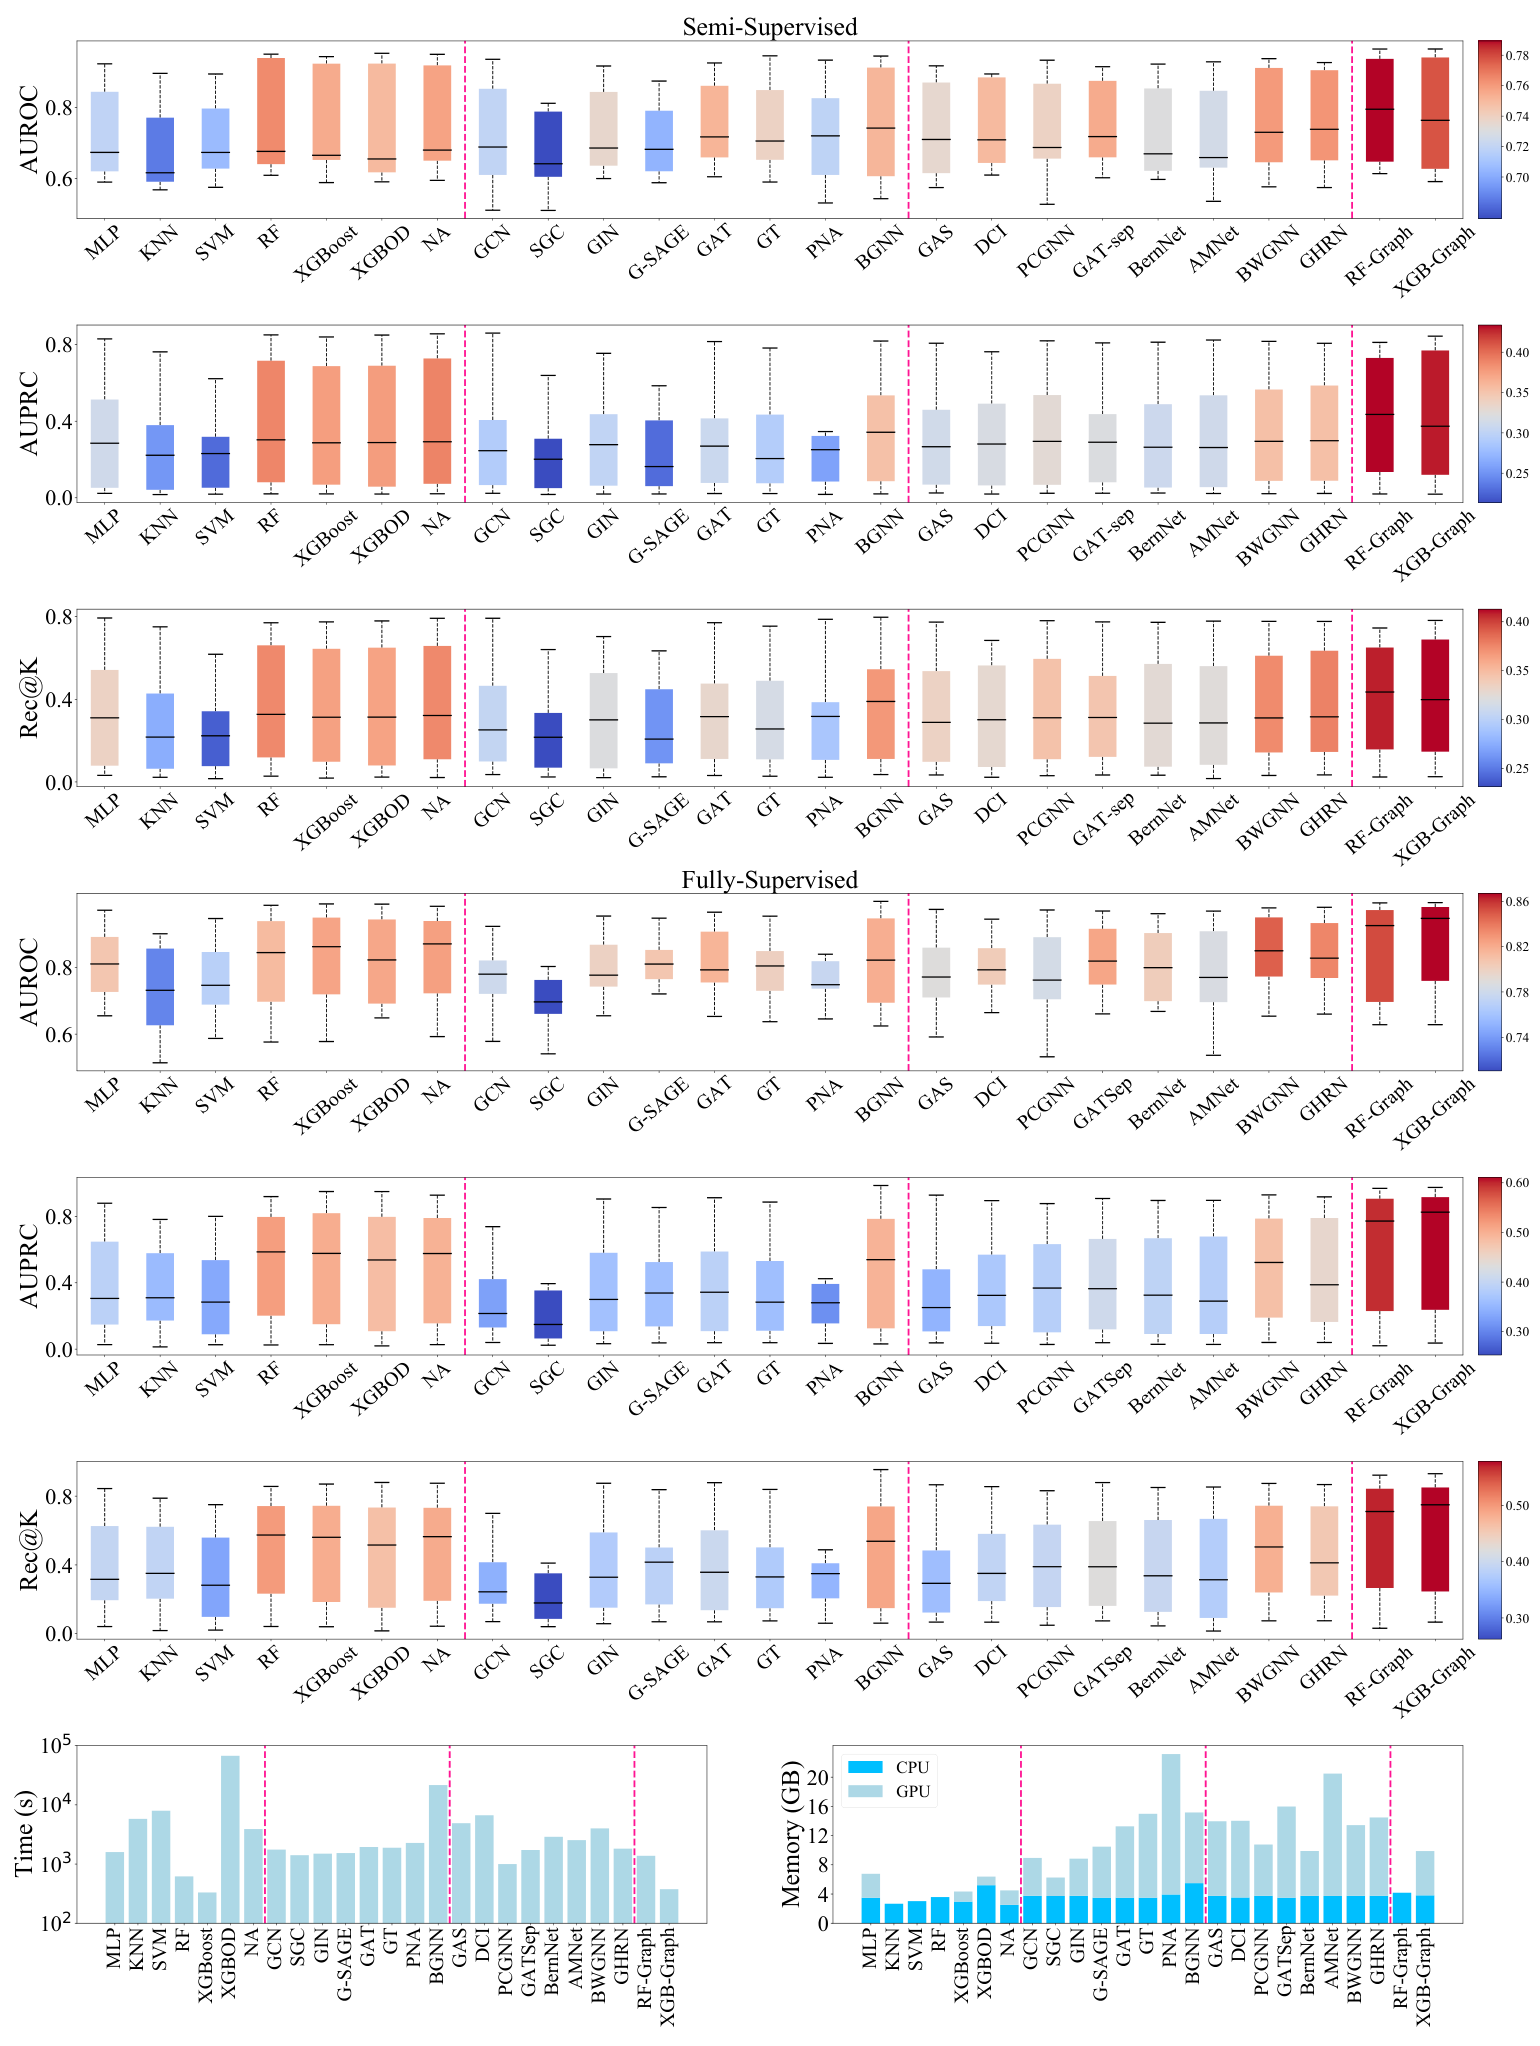
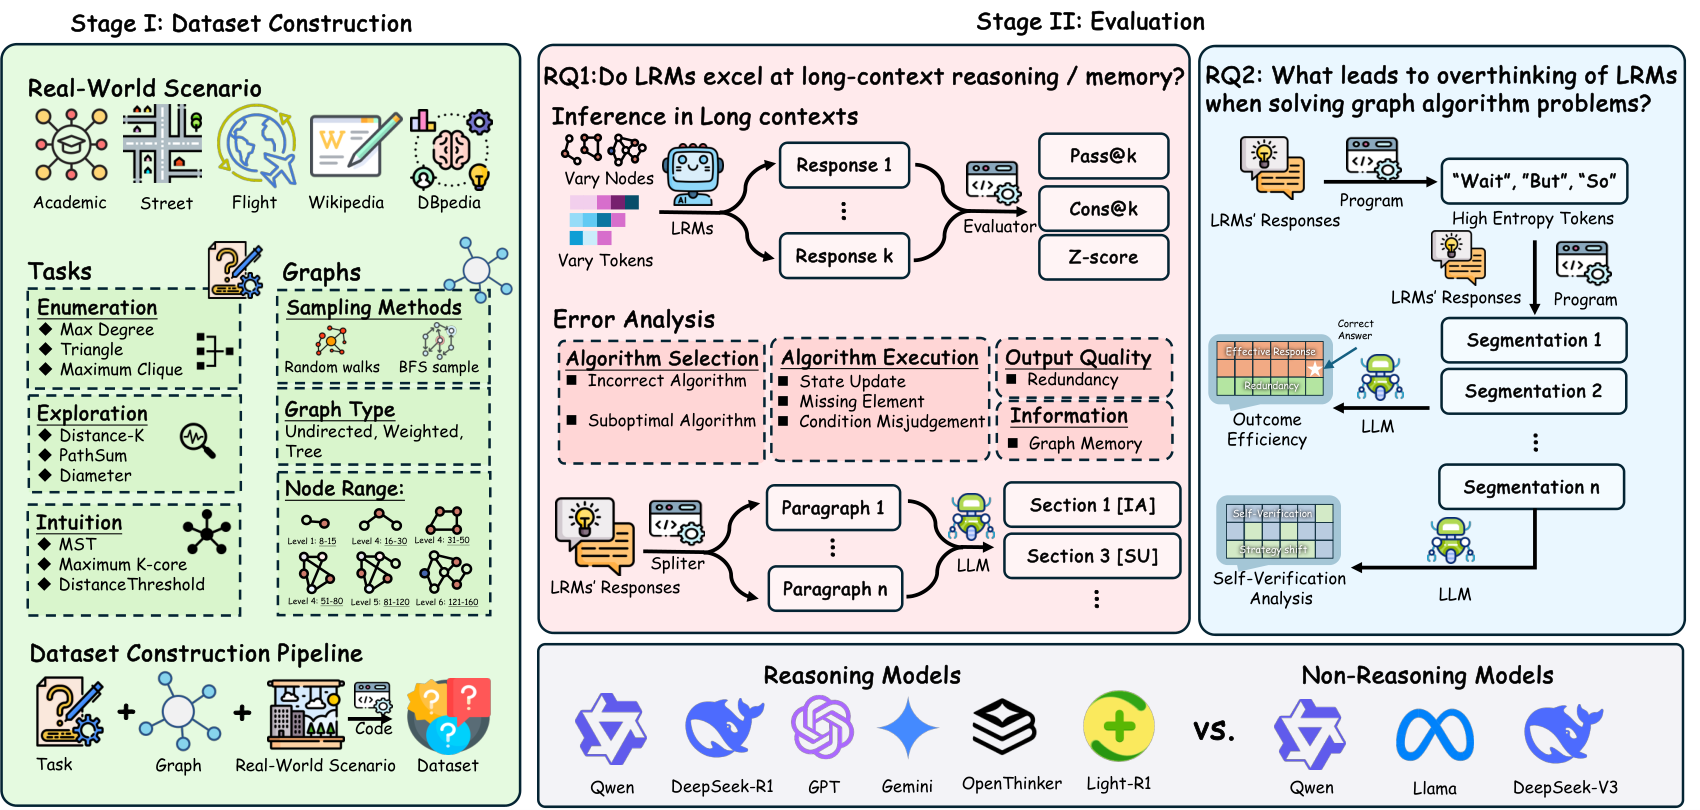
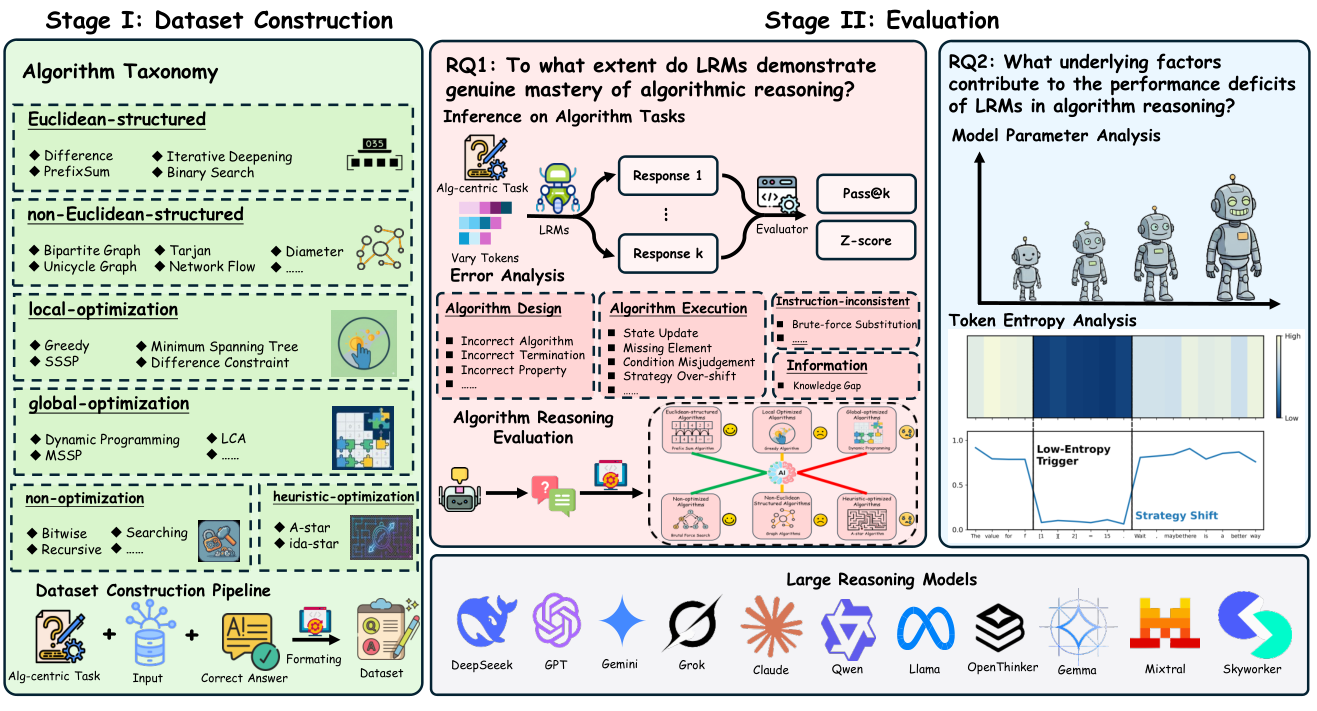
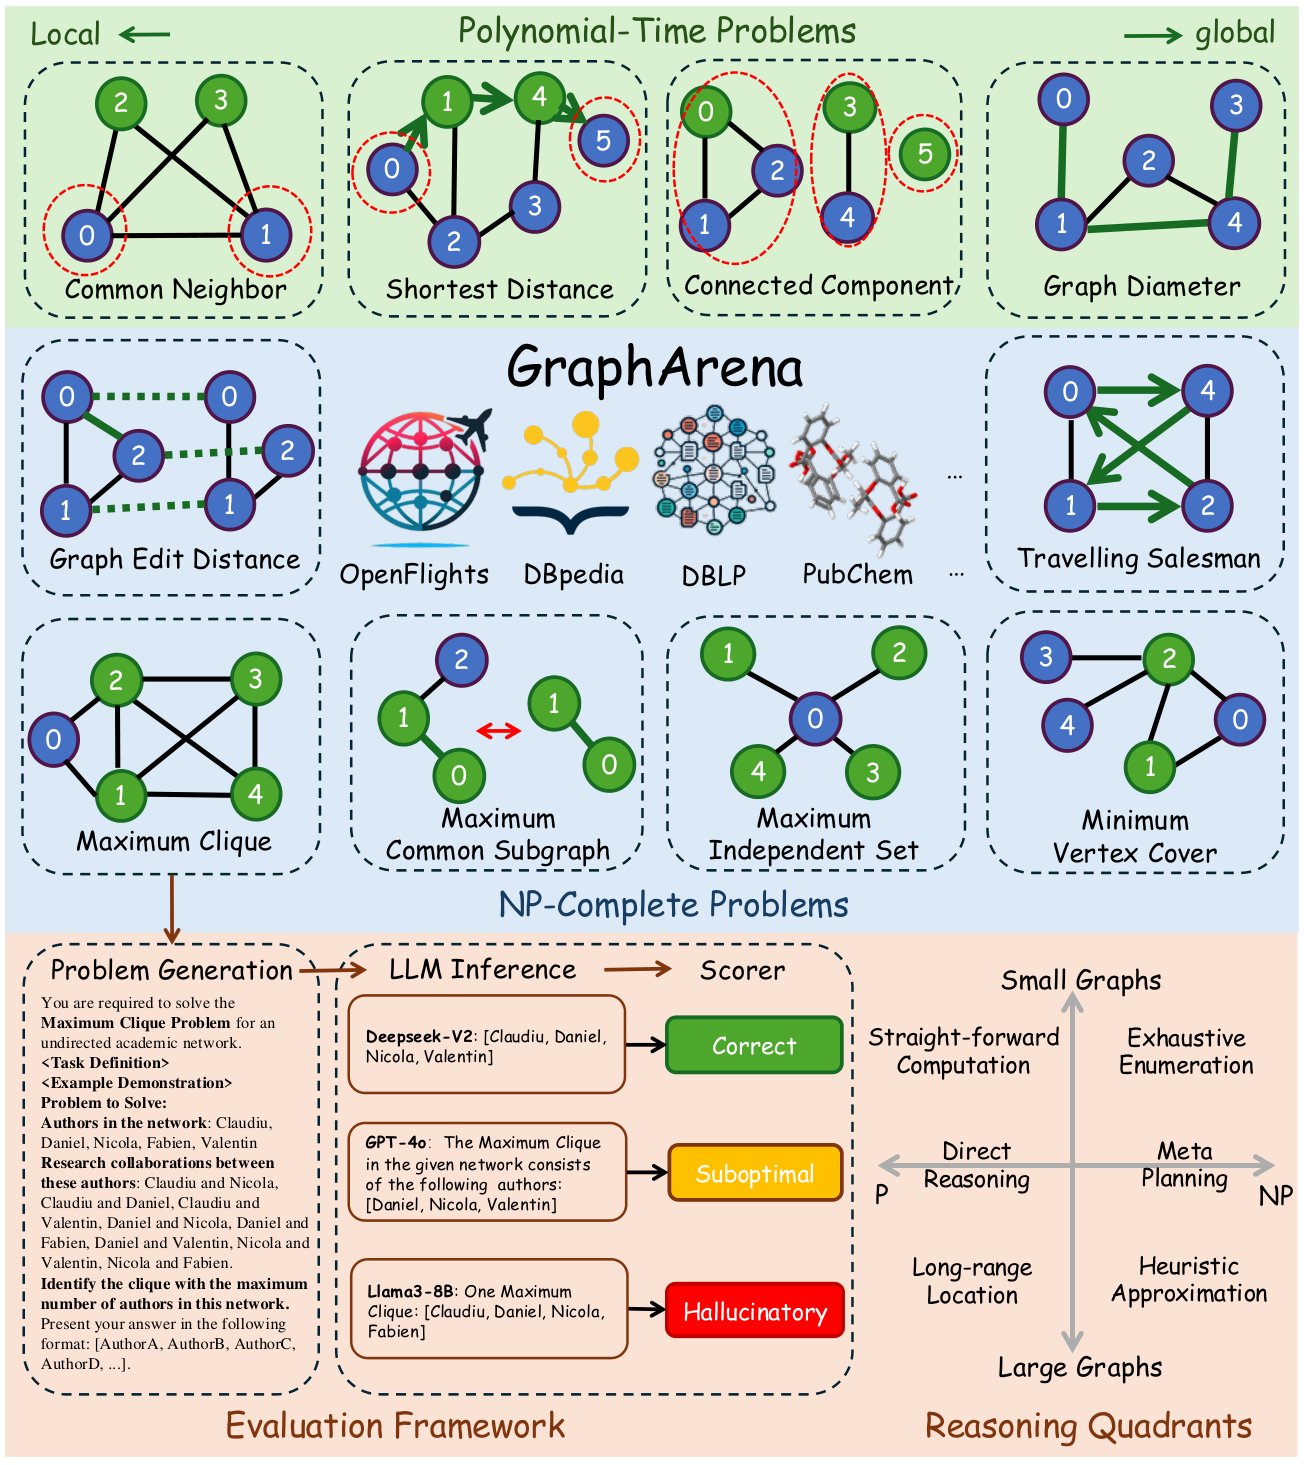
Benchmark 研究配图集,最上层为 GraphArena 评测框架 12Benchmarks
Verified research assetALLE / R-01
Benchmark systems

十余项模型能力
Benchmark

覆盖图推理、代码 Agent、检索与任务执行。每个项目都连接到公开研究材料与明确的评测问题。

可复现可验证能力回归
查看研究清单
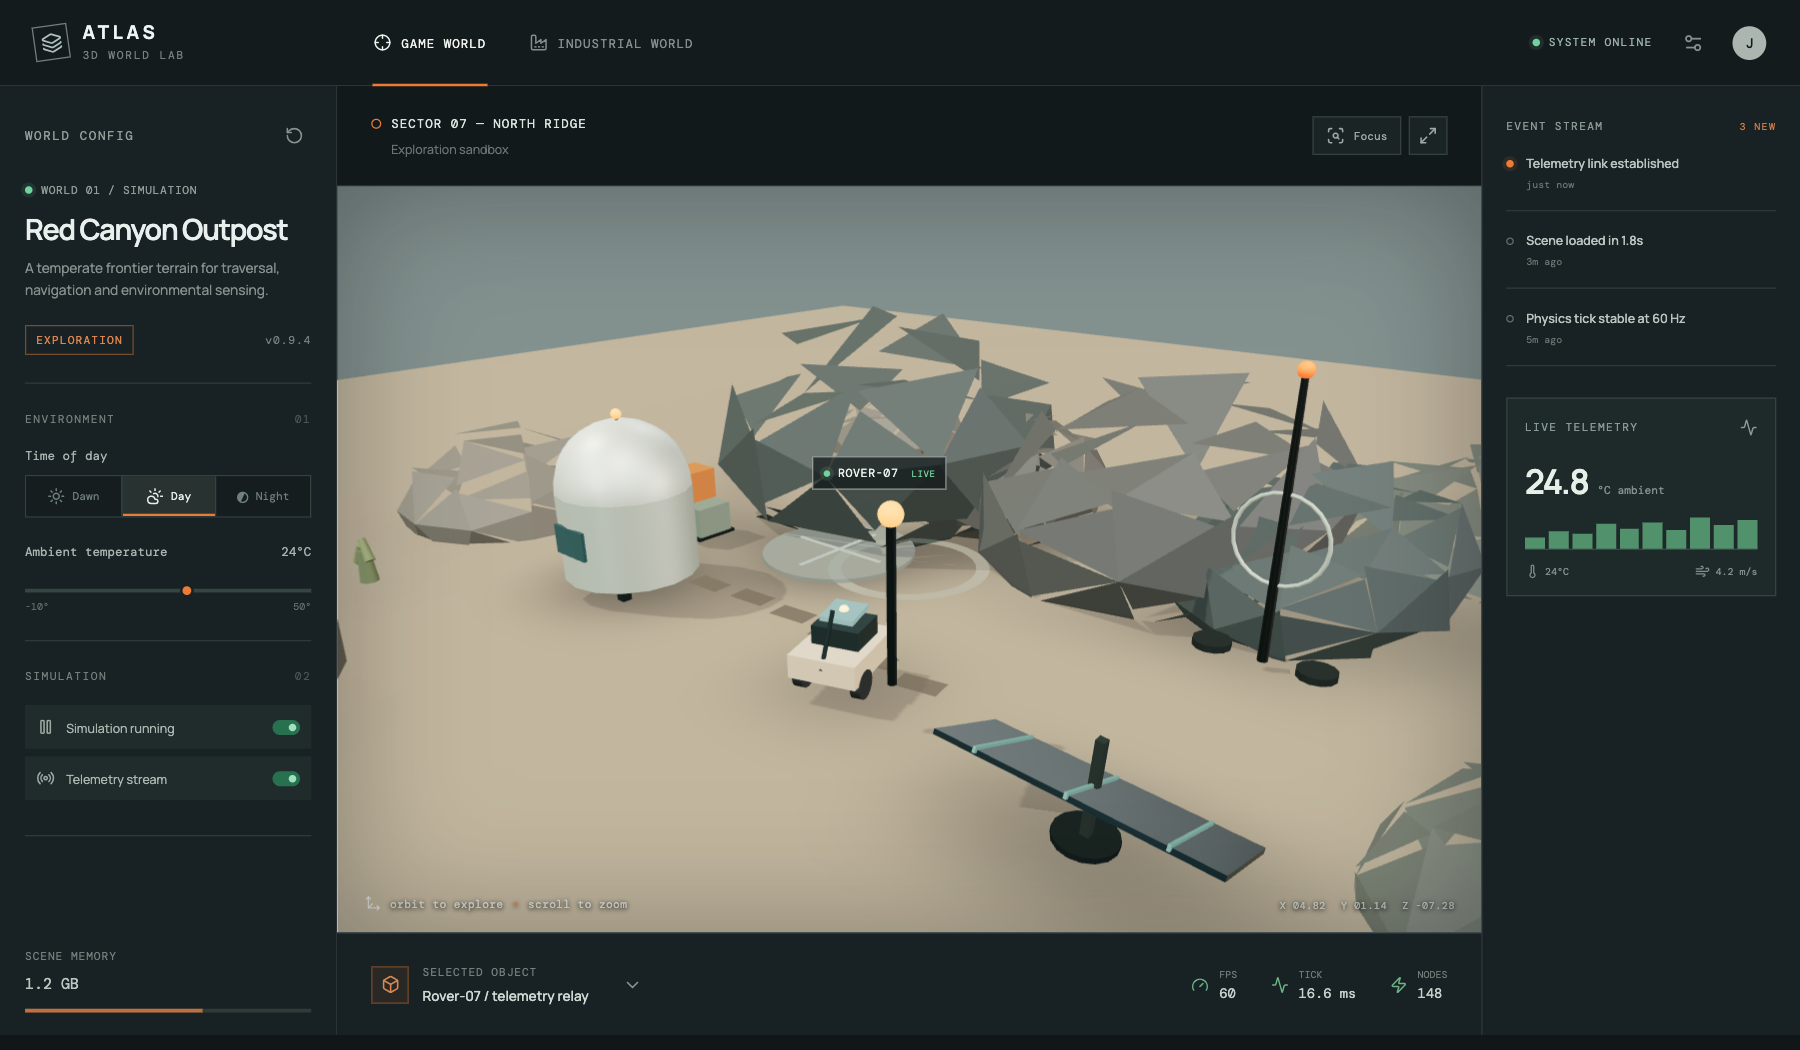
Environment / Interactive worldComplete research frame
ALLE Code2World 交互式世界界面截图,展示三维环境、环境配置与实时遥测面板
Interactive world systemALLE / R-02
Environment systems

Code2World

构建可生成、可执行、可回放、可验证的交互式世界,让环境本身成为可持续使用的研究基础设施。

可执行可回放环境生成
进入交互式世界
Video generationComplete research frame
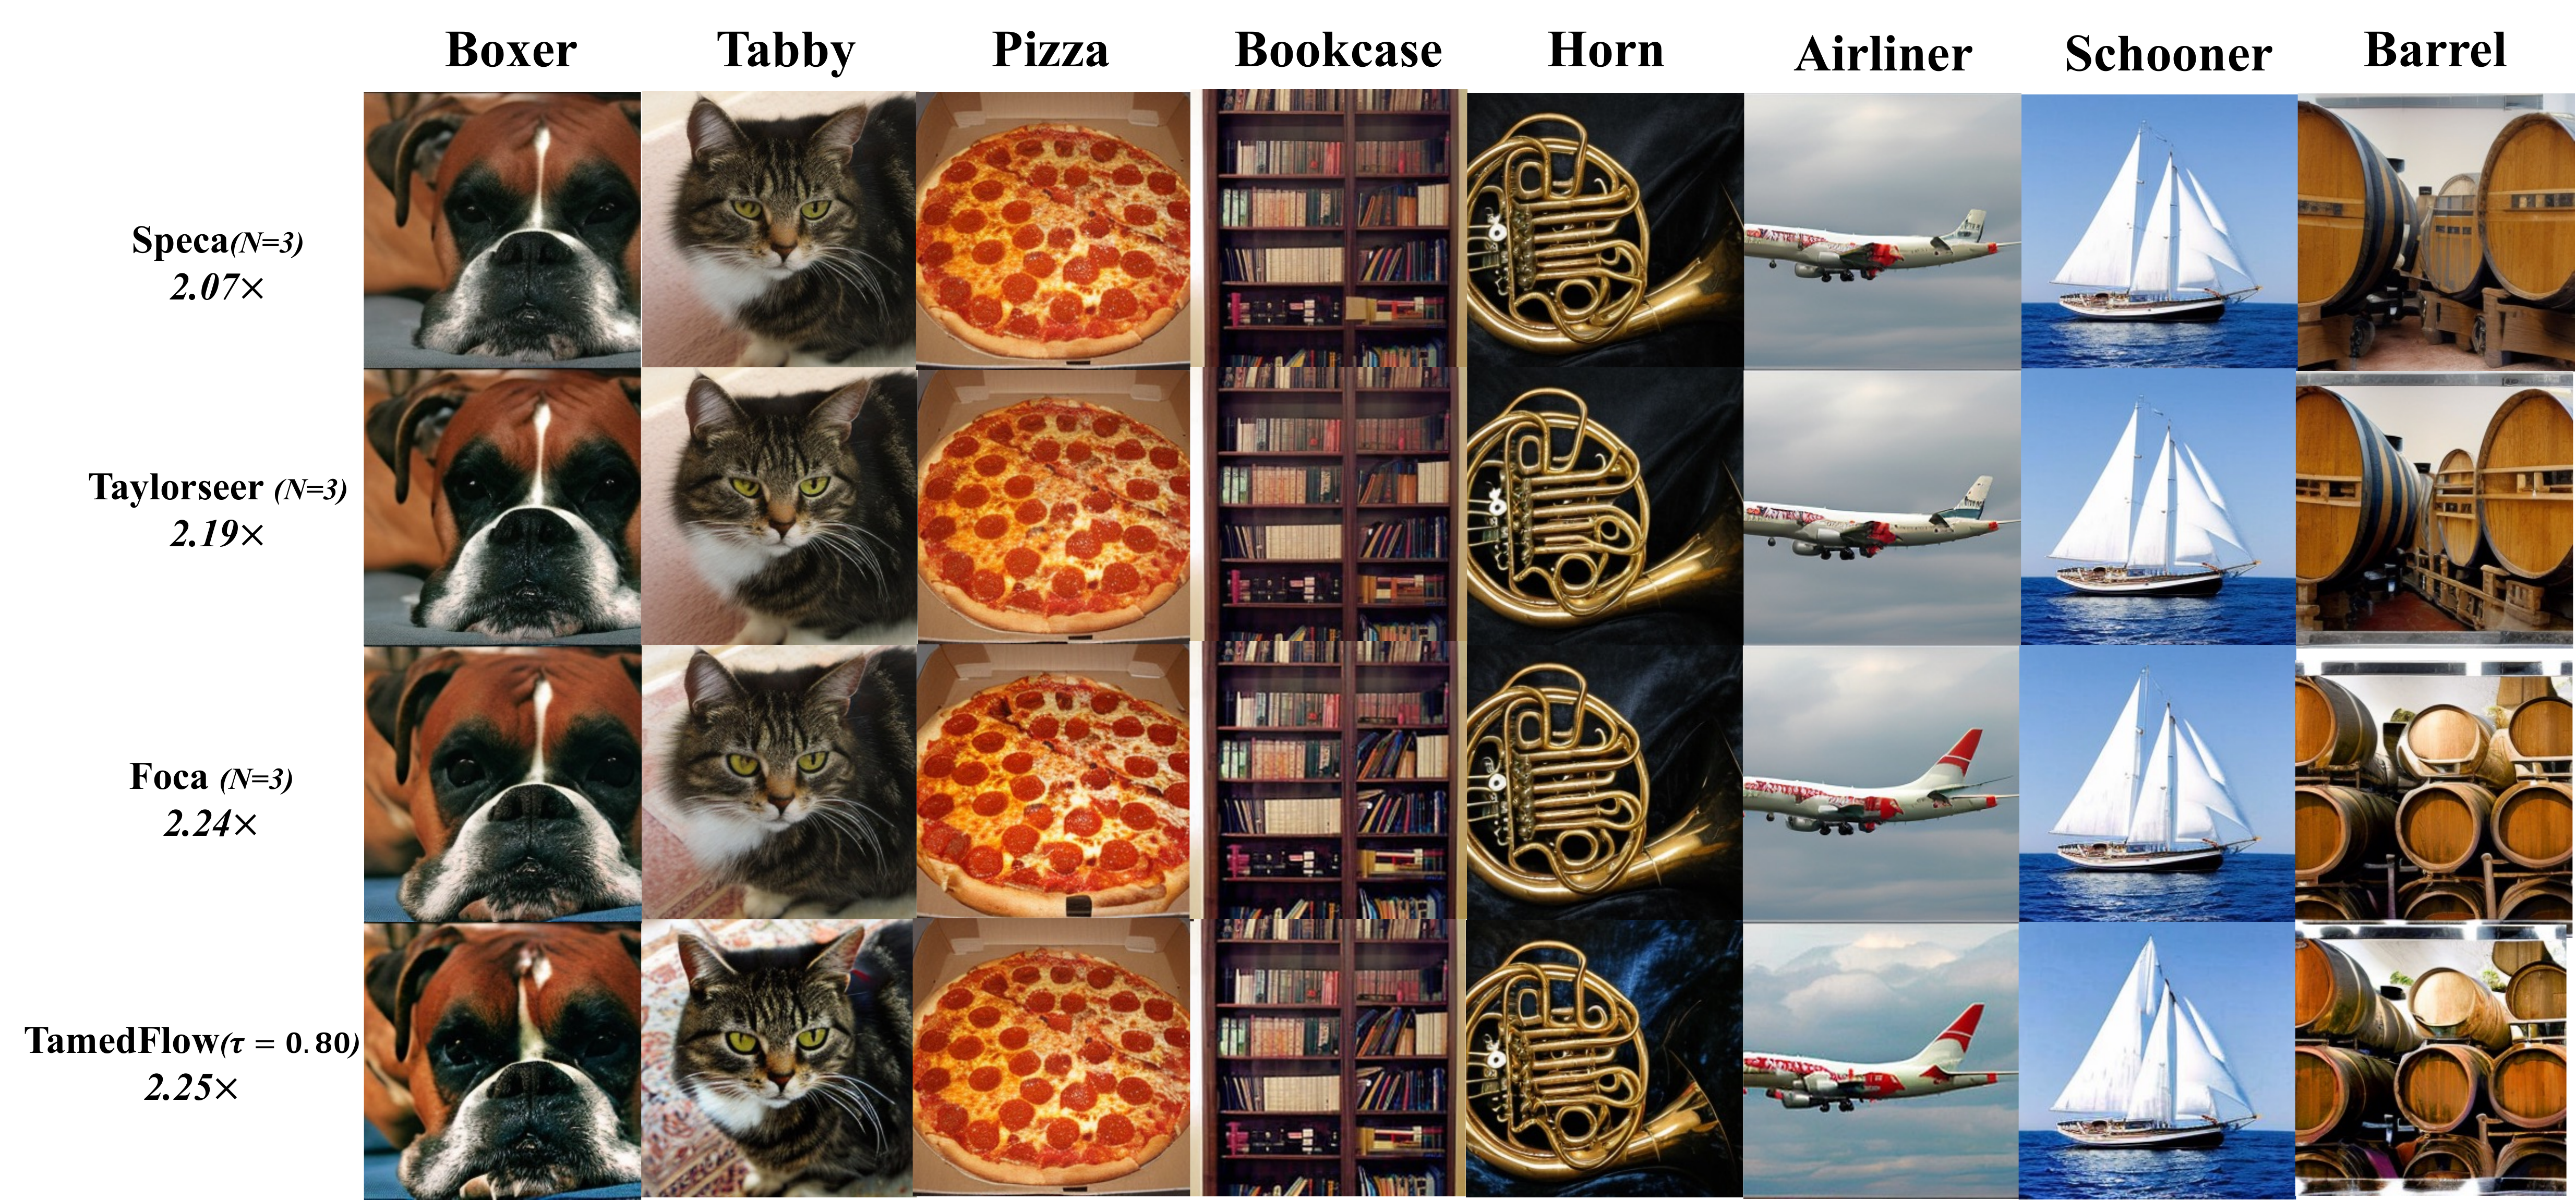
TamedFlow 视频生成研究结果,完整展示对比样例
Trajectory-aware distillationALLE / R-03
Generative systems

TamedFlow

轨迹感知蒸馏,在更少采样步数下保持质量与可控性,并用清晰对比呈现方法和结果。

视频生成轨迹蒸馏质量控制
查看方法与结果

Continuous research mechanism

一条从真实任务
走向能力资产的生产链。

不是把数据、评测和训练拆成孤立模块,而是在同一套环境与协议中持续记录、验证和沉淀。

01

任务与环境设计

把真实业务任务拆成可复现的环境、规则、状态与目标。

Output · Environment
02

Agent 执行

记录模型在工具、代码和环境中的连续决策与观测。

Output · Execution trace
03

轨迹与测试数据

统一采集状态、动作、测试、版本、失败样本和成本。

Output · Verified dataset
04

Benchmark / 训练服务

交付能力评测集,并在真实环境中训练、回放与定位回归。

Output · Capability asset
Deliverable specifications

我们提供的服务

每类交付都对应清晰的使用场景、验证方法和可继续迭代的工程接口。

S01

Benchmark

统一协议、可比较的能力证明,支持训练前选数据、训练中找回归和发布前验收。

S02

Agent 轨迹与测试数据

来自真实环境的高质量操作轨迹、测试结果、失败样本、版本和成本记录。

S03

环境训练与评测服务

在我们的执行环境中训练、回放和定位模型回归,让每轮能力变化有证据可查。

Why ALLE AI Lab

研究深度,
交付意识。

团队长期工作在模型评测、Agent、视频生成与数据基础设施的交叉处。我们关注的不只是论文结果,也包括资产如何被采购、训练、复现与验收。

10+Benchmark 研究项目
Code2World从代码走向交互式世界
可验证研究资产连接到明确来源
可复现任务、轨迹、测试与成本协议
Start a collaboration

让下一轮训练,
从可验证的任务开始。

预约合作
资琛义
Benchmark · 轨迹数据 · 训练服务
Business & research collaboration