Graph / ReasoningR / 01
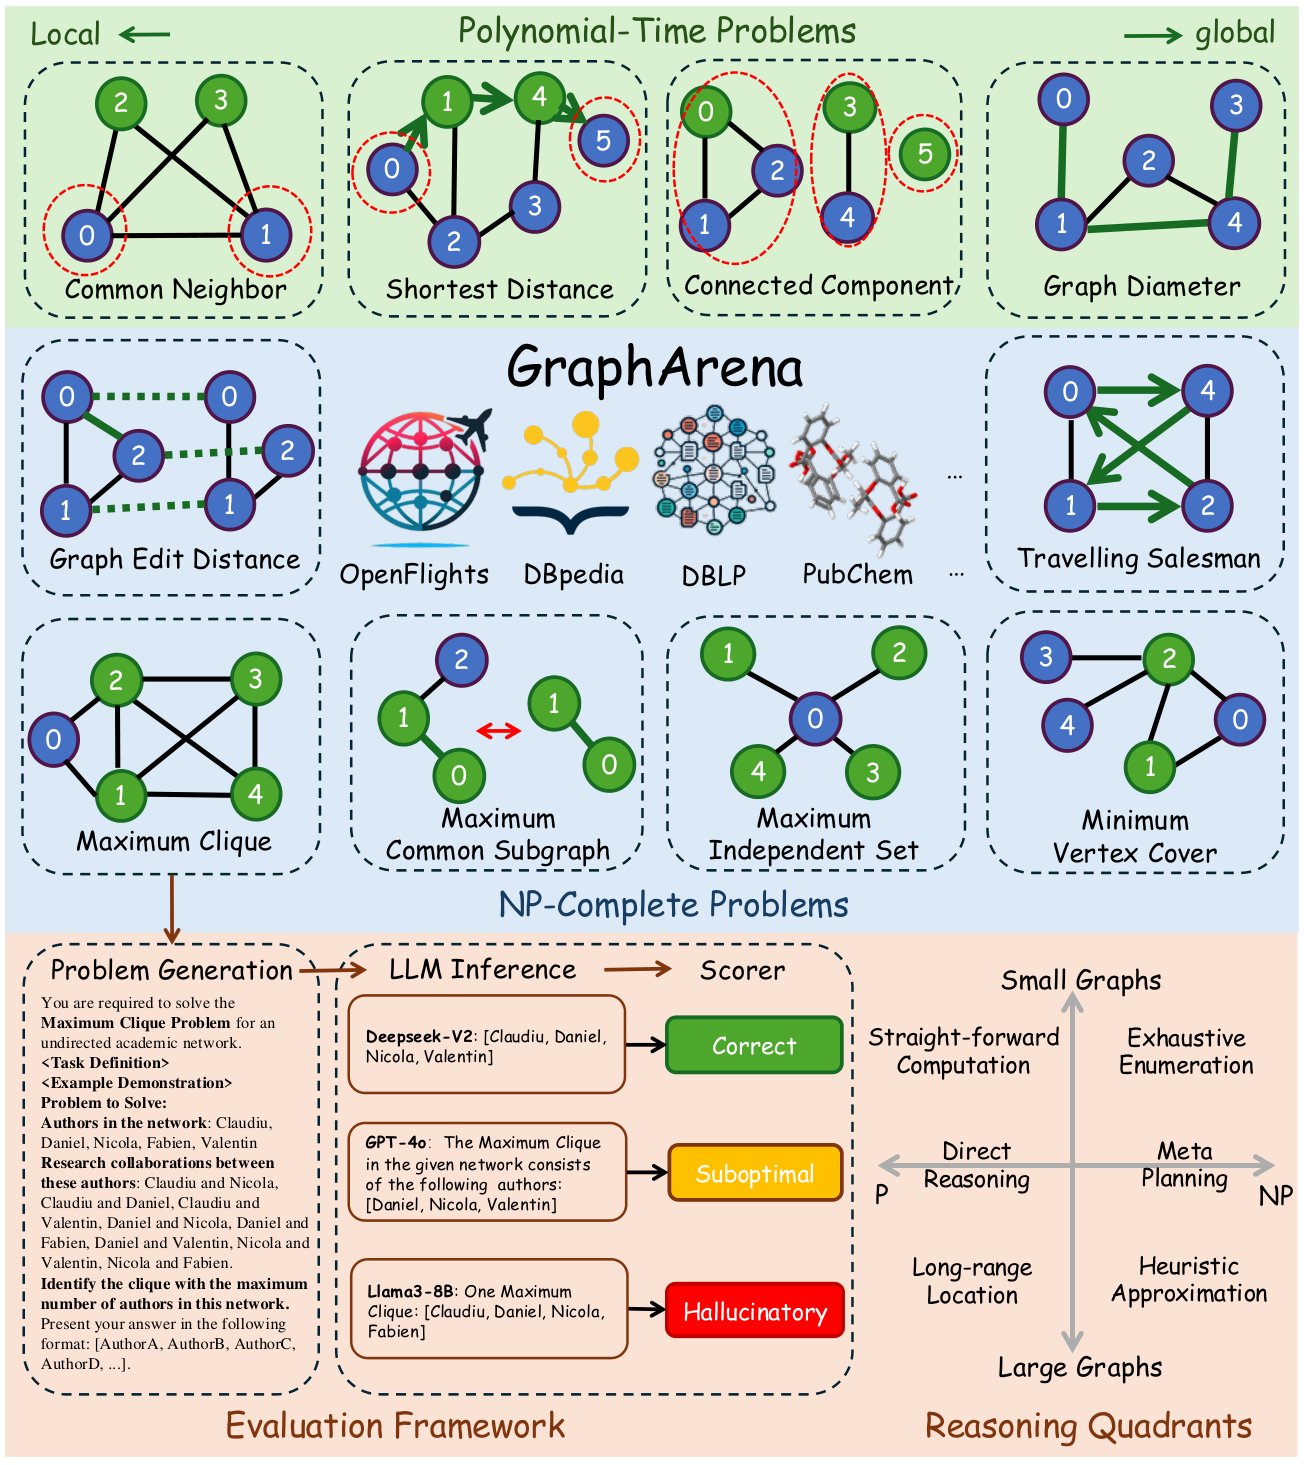
GraphArena
Evaluating and Exploring Large Language Models on Graph Computation
10 项图计算任务,覆盖多项式时间与 NP-complete 挑战,并将结果区分为正确、次优、幻觉和缺失。
图任务Agent 评测10 项任务
Benchmark 不只是排行榜。它帮助模型公司在训练前选数据、训练中找回归、发布前做验收,并把每一次实验变成可复用的能力证据。
 12Benchmarks
围绕训练与发布决策,保留可复查的评测记录。
Evaluating and Exploring Large Language Models on Graph Computation
10 项图计算任务,覆盖多项式时间与 NP-complete 挑战,并将结果区分为正确、次优、幻觉和缺失。